Comment la température et le system prompt influencent Gemma 4 E2B en local : protocole de 30 tests, script bash complet et résultats détaillés.

Comment la température et le system prompt influencent Gemma 4 E2B en local : protocole de 30 tests, script bash complet et résultats détaillés.
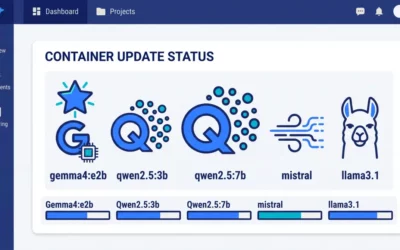
Comparatif de Gemma 4 E2B face à Qwen 2.5, Mistral et Llama 3.1 en local : protocole de test, script bash complet, résultats et limites de la méthode.

Découvre comment tester la pseudonymisation de documents chez toi avec Presidio, spaCy et Ollama : détecter les données personnelles, les traiter par IA sans jamais les exposer, puis réinjecter l’information réelle. Un workflow complet testé sur un PC modeste, avec le code et les limites observées.

Configure le RAG dans Open WebUI pour interroger tes documents en local avec Ollama et qwen2.5:3b. Embedding, base de connaissances, agent personnalisé : toutes les étapes sur Mini PC Ubuntu sans GPU, sans envoyer aucune donnée à l’extérieur.

Un seul prompt soumis à quatre modèles LLM en local – qwen2.5:3b, gemma2:2b, llama3.1 et mistral – pour les comparer sur la logique, la maîtrise du français et l’impact machine. Résultats concrets obtenus sur un mini PC Ubuntu « normal ».

Installe Ollama et Open WebUI sur Ubuntu avec Docker et Portainer pour faire tourner des modèles d’IA en local. Guide pas à pas avec les stacks Docker Compose.

Comment mettre à jour Ubuntu vers la dernière version stable sans réinstaller le système – les étapes complètes depuis le terminal ?