Tu as rédigé ton livre par chapitres dans Obsidian avec Longform (voir l’article précédent), et il faut maintenant en sortir un fichier Word exploitable, avec de vrais styles Titre 1, Titre 2, Titre 3. Voici la chaîne d’outils qui fonctionne, sans installer d’extension système lourde.
Pourquoi une exportation directe ne suffit pas
On se heurte à deux difficultés si on cherche à lire directement le fichier compilé dans Microsoft Word :
Les images ne sont pas intégrées au document compilé. Elles sont simplement reliées. Et ne s’affichent dans le document que si on le lit dans un lecteur de type VScode et seulement si le fichier est dans le même répertoire que les images.
Word ne peut pas (cf explication ci-dessous) lire correctement les balises <h1>, <h2>, <h3> en styles natifs Word Titre 1, Titre 2, Titre 3 : il les affiche comme des paragraphes « Normal » avec une mise en forme visuelle appliquée directement (gras, taille, couleur). En enregistrant ensuite en .docx, cette erreur est figée : le fichier final n’a aucun style de titre exploitable.
On passe donc par un enregistrement en mode Page Web, complète (.htm;.html) via un navigateur web pour que les images soient correctement incorporées au document. Et ensuite on utilise LibreOffice car il a un moteur de conversion HTML qui associe strictement les balises <h1>, <h2>, <h3> aux vrais styles Titre 1, Titre 2, Titre 3 du format .docx.
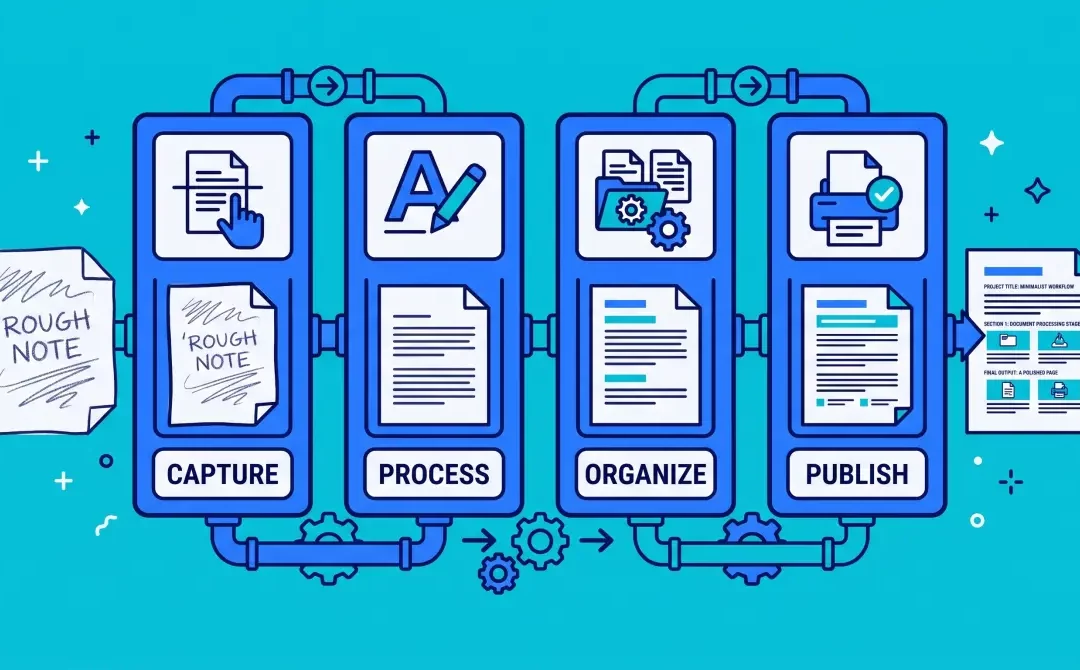
Vue d’ensemble de la chaîne d’outils
Obsidian (Longform)
      ↓ compilation (fichier manuscrit.md)
VSCodium (export HTML Offline)
      ↓ (fichier manuscrit.html)
Navigateur web (Enregistrer en "Page Web complète .htm")
      ↓ (fichier manuscrit.html qui contient ses propres images)
Gestionnaire de fichier windows (renommage en .doc)
      ↓ (fichier manuscrit.doc)
LibreOffice Writer (pivot de conversion vers .docx)
      ↓ (fichier manuscrit.docx avec titres en styles et pas en mode "normal")
Microsoft Word ou Google Docs (fichier final avec styles modifiables)
Étape 1 : compiler le manuscrit avec Longform
Toutes tes images doivent être regroupées dans un seul dossier du vault (_Illustrations dans l’article précédent), sans quoi elles ne suivront pas lors de l’export.
Dans le panneau Longform, onglet Compile :
Vérifie l’ordre des scènes/chapitres (glisser-déposer si besoin)
Coche Strip Frontmatter, pour supprimer les métadonnées YAML du haut de chaque fichier
Coche ou décoche Insert Chapter Titles selon que tes titres de chapitre sont déjà écrits dans le texte de chaque scène, ou seulement définis dans les propriétés
Lance la compilation
Longform génère un fichier unique, par exemple manuscrit.md, dans le dossier de tes scènes.
Étape 2 : exporter en HTML avec VSCodium
Le fichier à exporter doit être placé dans le dossier _Illustrations, sans quoi les images ne suivront pas. Le fichier HTML se crée aussi dans ce dossier.
Ouvre le fichier compilé (manuscrit.md) avec VSCodium
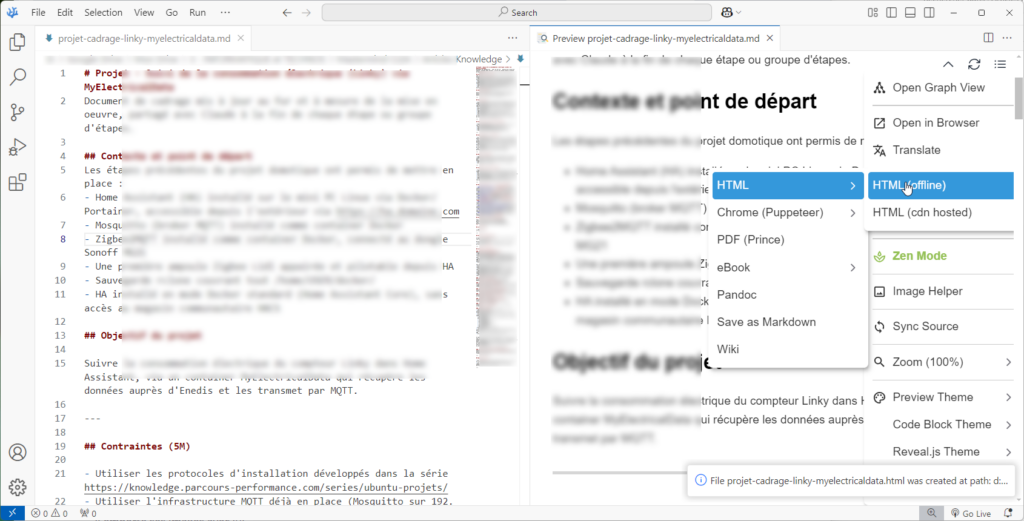
Ouvre l’aperçu Markdown Preview Enhanced (Ctrl+K puis V). Si nécessaire installe l’extension Markdown Preview Enhanced dans VSCodium.
Dans le panneau d’aperçu, clic droit n’importe où sur la page
Choisis HTML puis HTML (Offline)
Résultat : un fichier manuscrit.html est créé à côté de tes fichiers Markdown.
Étape 3 : « Page Web complète » depuis le navigateur
Le fichier HTML doit lui aussi être dans _Illustrations pour cette étape. Le fichier .htm obtenu, lui, pourra être déplacé ailleurs ensuite, car il emporte ses images avec lui.
Ouvre manuscrit.html dans un navigateur (Chrome, Edge, Firefox)
Clic droit sur la page, Enregistrer sous… (ou Ctrl+S)
Dans le champ Type, sélectionne impérativement Page Web, complète (.htm;.html)
Choisis le dossier de destination et valide
Résultat : un fichier .html (par exemple manuscritComplet.html) qui intègre les images.
Étape 4 : pivot par LibreOffice Writer
C’est le point le plus sensible de la chaîne. Ouvrir directement le fichier .htm dans LibreOffice Writer ne fonctionne pas de façon fiable, le résultat dépend de la méthode d’ouverture utilisée. La seule méthode qui fonctionne à coup sûr :
Fais une copie du fichier .htm
Renomme cette copie avec l’extension .doc (par exemple manuscritComplet.doc)
Ouvre ce fichier .doc avec LibreOffice Writer
Vérifie que les niveaux de titre sont bien reconnus (Titre 1, Titre 2, Titre 3 dans le volet des styles)
Enregistre sous format .docx
Étape 5 : finaliser dans Word ou Google Docs
Ouvre le fichier .docx obtenu avec Microsoft Word, ou dépose-le dans Google Drive pour l’ouvrir avec Google Docs.
Les titres sont reconnus avec les vrais styles Word (Titre 1, Titre 2, Titre 3), modifiables en un clic depuis le volet des styles
Les images apparaissent à leur emplacement, mais pas à la largeur définie dans Obsidian, il faut les redimensionner manuellement (voir la macro ci-dessous)
Le fichier .docx est autonome, il n’a plus besoin des fichiers sources
Redimensionner et centrer les images automatiquement
Écrire ![[image.png|550]] dans Obsidian ne suffit pas à contrôler la taille finale dans Word : les images arrivent à leur taille d’origine après le passage par la chaîne d’export. Cette macro Word parcourt le document et réduit à 15 cm toutes les images qui dépassent cette largeur, proportions conservées, puis les centre.
Dans Word, Alt + F11 pour ouvrir l’éditeur de macro (ou onglet Développeur > Visual Basic)
Menu Insert > Module
Colle le code suivant :
vba
Sub RedimensionnerEtCentrerImages()
    Dim img As InlineShape
    Dim maxLargeurCm As Single
    Dim maxLargeurPoints As Single

    ' Définition de la largeur max à 15 cm
    maxLargeurCm = 15
    maxLargeurPoints = CentimetersToPoints(maxLargeurCm)

    ' Parcours de toutes les images du document
    For Each img In ActiveDocument.InlineShapes
        If img.Type = wdInlineShapePicture Or img.Type = wdInlineShapeLinkedPicture Then
            ' Redimensionnement si nécessaire
            If img.Width > maxLargeurPoints Then
                img.LockAspectRatio = msoTrue
                img.Width = maxLargeurPoints
            End If

            ' Alignement centré du paragraphe contenant l'image
            img.Range.ParagraphFormat.Alignment = wdAlignParagraphCenter
        End If
    Next img

    MsgBox "Toutes les images ont été ajustées (15 cm max) et centrées !", vbInformation, "Terminé"
End Sub
Enregistre : Word te proposera de conserver le format .docx sans macro, refuse et enregistre le document au format acceptant les macros
F5 (ou le bouton Lecture) pour exécuter la macro
Une autre piste, non testée dans vscodium : Pandoc
Pandoc, avec l’extension « Obsidian Pandoc » ou en ligne de commande, permettrait probablement d’exporter directement vers un .docx exploitable, sans passer par tout ce détour. Je ne l’ai pas testé : ça suppose d’installer un outil externe dont je ne connaissais pas la fiabilité, pour un besoin ponctuel. Si tu es plus à l’aise avec l’installation d’outils en ligne de commande, ça vaut sans doute le coup d’essayer avant de te lancer dans la chaîne décrite ici.
Limites connues, pour une prochaine fois
Les propriétés de titre ne sont pas correctement reprises à la compilation : c’est le nom du fichier qui est utilisé comme titre, pas la propriété titre définie dans le modèle
La macro de redimensionnement s’applique à toutes les images sans distinction : des petites images déjà à la bonne taille (par exemple des schémas illustratifs) se retrouvent elles aussi recentrées, alors qu’elles devraient rester alignées avec le texte
Les tableaux ne sont pas redimensionnés à la largeur du texte, ni alignés verticalement au centre, un ajustement manuel reste nécessaire
Écrire un livre (un essai dans mon cas, pas un roman), ce n’est pas seulement rédiger : c’est aussi retrouver un personnage cité au chapitre 3 quand on l’évoque au chapitre 9, savoir quel chapitre est prêt et lequel ne l’est pas, et un jour assembler tout ça en un seul document. Voici comment répondre à ces besoins dans Obsidian.
Ce dont tu as besoin pour écrire un livre sans t’y perdre
Au fil de la rédaction, plusieurs besoins reviennent, quel que soit le sujet du livre :
Une structure globale : voir l’ensemble des chapitres, les réorganiser facilement, sans dépendre de l’ordre dans lequel les fichiers ont été créés
Un espace de travail par chapitre : rédiger un chapitre sans que les notes de travail (idées, sources, remarques à soi-même) se mélangent au texte final
Un endroit où vont se ranger les images et autres éléments que je colle dans les chapitres ou notes.
Une mémoire des personnages et des notions récurrentes : éviter d’oublier qu’un personnage a déjà été présenté ailleurs, ou de redéfinir deux fois la même notion. Si tu ancres tes idées dans des cas concrets comme moi, tu auras vite affaire à de nombreux personnages, dont la vie professionnelle inspirera tes lecteurs.
Une vue d’ensemble de l’avancement : savoir en un coup d’œil quels chapitres sont terminés, lesquels restent à relire, et quelles questions sont encore en suspens
Un moyen de générer le manuscrit complet : assembler tous les chapitres, dans l’ordre, en un seul fichier propre
Des sauvegardes régulières : un projet de plusieurs mois de travail ne peut pas reposer uniquement sur la synchronisation entre appareils
Comment y répondre : la solution retenue
Trois extensions Obsidian couvrent ces besoins, chacune sur un point précis.
Besoin
Réponse
Extension
Structure globale, réorganisation des chapitres
Panneau dédié avec glisser-déposer, compilation en un clic
Longform
Isoler le texte final des notes de travail, chapitre par chapitre
Un fichier texte et un fichier notes par chapitre
Organisation du vault (pas d’extension)
Stocker les images et pièces jointes sans les disperser dans le vault
Dossier dédié aux pièces jointes, configuré une fois pour toutes
Réglage natif d’Obsidian (pas d’extension)
Fiches de personnages et de notions sans repartir de zéro
Modèles de fichiers pré-remplis
Templater
Vue d’ensemble de l’avancement
Tableau de bord qui se met à jour automatiquement
Dataview
Protection contre les fausses manipulations
Historique automatique des fichiers
File Recovery (natif)
Sécurité du projet dans son ensemble
Sauvegarde périodique indépendante de la synchronisation
Voir l’article dédié, mentionné plus bas
Concrètement : chaque chapitre vit dans son propre dossier, avec un fichier texte.md (ce que lira le lecteur) et des fichiers notes.md (tout le reste). Longform assemble tous les texte.md, dans l’ordre que tu définis, pour produire le manuscrit final. Templater crée automatiquement des fiches à structure identique pour chaque personnage ou notion récurrente, à partir de modèles que tu ne rédiges qu’une seule fois. Dataview scanne l’ensemble du vault pour construire un tableau de bord : état de chaque chapitre, tâches en attente, questions non résolues.
La suite de l’article détaille la mise en œuvre technique de chaque brique. Si la vision d’ensemble te suffit pour l’instant, tu peux t’arrêter ici et y revenir plus tard.
Mise en œuvre technique
On considère que tu as installé les extensions dans ton vault.
Organiser le vault
Chaque chapitre repose sur un fichier texte, et un ou plusieurs fichiers de notes :
texte.md : le texte destiné au lecteur, le seul compilé par Longform
notes.md et d’autres fichiers de notes si besoin : tout le reste (notes de travail, sources, instructions à soi-même)
mon-livre/
│
├── 00-Avant-propos/
│   ├── texte.md
│   └── notes.md
├── 01-Introduction/
├── Partie-1/
│   ├── Chapitre-01/
│   ├── Chapitre-02/
├── Partie-2/
│   ├── Chapitre-03/
├── _Personnages/          ← fiches des personnages ou cas cités
├── _Concepts/              ← fiches de notions transversales
├── _Illustrations/          ← toutes les pièces jointes
├── _Templates/             ← modèles de fichiers
├── _Versions/               ← archives manuelles
└── _Tableau-de-bord.md    ← vue d'ensemble du projet
Le préfixe _ fait remonter ces dossiers en haut de l’explorateur de fichiers.
Ranger les images automatiquement
Pour éviter de disperser les illustrations dans les dossiers de chapitres, configure un dossier unique pour toutes les pièces jointes :
Ouvre Paramètres > Fichiers et liens
Dans « Emplacement par défaut des nouvelles pièces jointes », choisis « Dans le dossier indiqué ci-dessous »
Indique _Illustrations
Toute image collée ou glissée dans un chapitre atterrit désormais automatiquement dans ce dossier, quel que soit l’endroit où tu la colles.
Convention de nommage
Pour retrouver facilement une image et savoir d’où elle vient, nomme-la selon le schéma partie-chapitre-description, par exemple :
P2-02-secret.png
P2 pour la partie 2, 02 pour le chapitre 2, secret pour une description courte du contenu.
Insérer une image dans un chapitre
Utilise la syntaxe Wikilink standard, avec le nom du fichier tel qu’il apparaît dans _Illustrations :
![[P2-02-secret.png]]
Pour limiter sa largeur d’affichage, ajoute la largeur en pixels après un | :
![[P2-02-secret.png|500]]
Cette image s’intègre automatiquement dans le manuscrit compilé par Longform, sujet détaillé dans l’article suivant.
Configurer Longform
Créer le projet
Clic droit sur le dossier racine du vault
Sélectionner « Créer un projet Longform »
Nommer le projet
Choisir le format multi-scènes
Longform crée un fichier pivot qui sert de colonne vertébrale au manuscrit.
Gérer l’ordre des chapitres
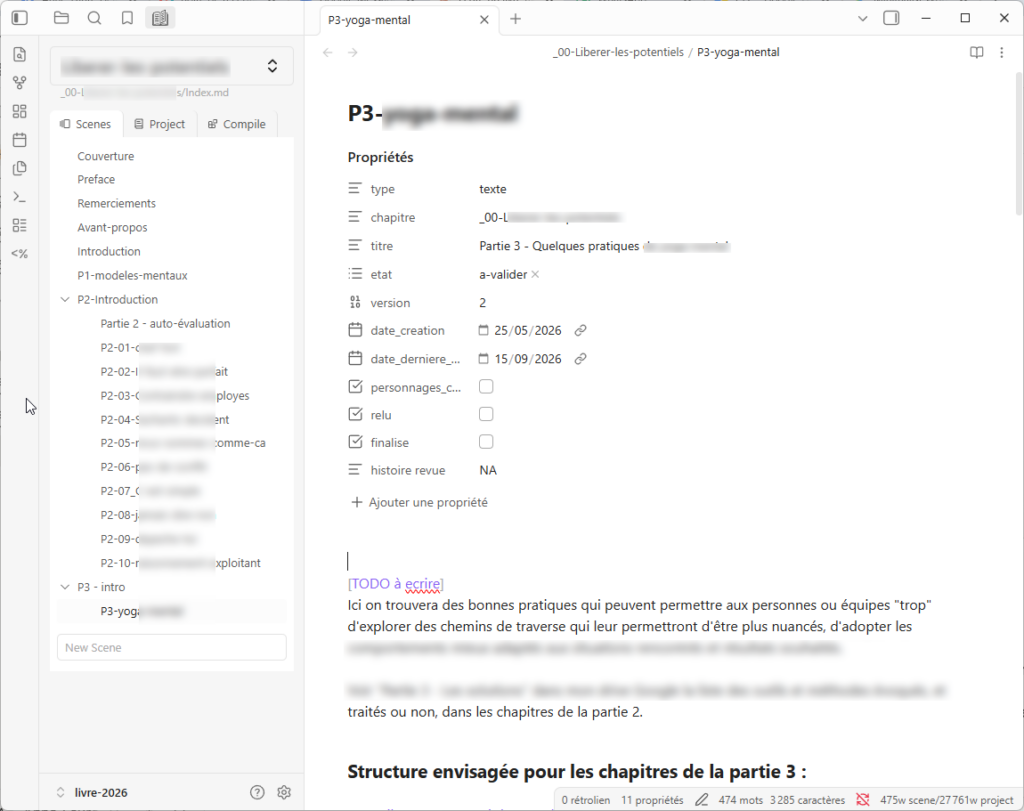
L’ordre des scènes se gère dans le panneau Longform (icône dans la barre latérale gauche), onglet « Scenes ». Les chapitres se réorganisent par glisser-déposer, sans éditer de fichier YAML à la main. L’indentation dans ce panneau permet de créer des hiérarchies (parties > chapitres) sans toucher aux dossiers physiques.
Gérer les versions de rédaction (Drafts)
Longform permet de créer plusieurs brouillons d’un même projet (V1, V2…) via l’onglet « Project ». Chaque brouillon conserve sa propre structure de scènes, ce qui permet de restructurer une V2 tout en gardant la V1 intacte.
Configurer Templater
Configuration initiale
Dans Paramètres > Templater :
Template folder location : _Templates
Trigger Templater on new file creation : activer
Folder Templates : associer chaque dossier à son modèle
Dossier
Modèle
_Personnages
modele-fiche-personnage
_Concepts
modele-fiche-concept
Pour les dossiers de chapitres (modele-texte-chapitre.md et modele-notes-chapitre.md), mieux vaut passer par la palette de commandes au moment de créer le fichier (voir ci-dessous), plutôt que par une association automatique.
Utilisation au quotidien
Deux façons d’appliquer un modèle :
Créer un fichier dans un dossier associé : Templater l’applique automatiquement
Ou : Ctrl+P > « Templater : Insert template » > choisir le modèle manuellement
Les modèles de fichiers
J’ai créé 4 fichiers dans _Templates/ avant de commencer la rédaction. Je te montre le premier modèle. Les autres sont sur le même principe.
Les valeurs possibles pour le champ etat : a-nettoyer / en-cours-nettoyage / nettoye / a-relire / finalise.
La procédure de nettoyage d’un chapitre
Sept étapes, à répéter pour chaque chapitre.
1. Créer les fichiers du chapitre
Dans le dossier du chapitre, crée texte.md et des fichiers notes.md à partir des modèles Templater.
2. Coller le contenu brut
Copie le contenu du chapitre depuis ton brouillon global. Colle-le dans texte.md.
3. Trier
A déplacer dans notes.md
A garder dans texte.md
« Illustration possible : … »
Tout le texte rédigé
« Voir aussi [lien web] »
Les citations
« A exploiter / à creuser »
Les exemples et cas concrets
Sorties ChatGPT/Gemini brutes
Les tableaux
Questions à soi-même
Le récapitulatif
4. Baliser les tâches restantes
Dans texte.md, signale les passages à retravailler avec la syntaxe de tâche Markdown :
- [ ] Revoir ce passage - manque d'exemple #todo
- [ ] Vérifier la cohérence avec le chapitre 3 #coherence
Dataview les centralisera automatiquement dans le tableau de bord.
5. Mettre à jour l’en-tête
Change etat et date_derniere_modif dans le bloc YAML.
6. Créer ou compléter les fiches
Pour chaque personnage ou concept mentionné dans le chapitre, vérifie s’il a une fiche dans _Personnages/ ou _Concepts/, crée-la si besoin.
7. Lier les chapitres entre eux
Dans certains fichiers de notes, section « Liens vers autres chapitres » :
- Renforce [[Chapitre-04/texte]]
- Contraste avec [[Chapitre-06/texte]]
- Lien avec concept [[_Concepts/Concept-A]]
Le tableau de bord avec Dataview
Contenu de _Tableau-de-bord.md. Les requêtes se mettent à jour automatiquement à chaque modification du vault.
Etat des chapitres
TABLE titre, etat, relu, finalise
FROM "/"
WHERE type = "texte"
SORT chapitre ASC
Tâches en suspens dans le manuscrit
TASK
FROM "/"
WHERE !completed
SORT file.name ASC
Questions en suspens
TABLE question AS "Question", file.name AS "Chapitre"
FROM "/"
WHERE question != null
Concepts par famille
TABLE famille
FROM "_Concepts"
WHERE type = "concept"
SORT famille ASC
Gérer les versions
Protection automatique : File Recovery
Obsidian sauvegarde automatiquement des instantanés de chaque fichier toutes les 5 minutes. Pour restaurer : Paramètres > Plugins principaux > File Recovery > View. Tu cherches le fichier, tu vois l’historique, tu restaures la version choisie.
Protection manuelle avant révision importante
Avant toute révision importante, notamment avant de travailler avec une IA :
Copie le fichier texte.md dans _Versions/
Renomme-le avec la date, par exemple Chapitre-03-2026-05-20.md
Travaille sur le fichier original
Brouillons Longform pour les restructurations majeures
Si tu envisages de modifier l’ordre des chapitres ou de fusionner des parties, crée un nouveau Draft dans Longform plutôt que de modifier directement. La version précédente reste intacte pour comparaison ou restauration.
Sauvegardes : ne pas s’arrêter à la synchronisation
File Recovery protège contre une fausse manipulation locale, mais ni File Recovery ni la synchronisation ne protègent contre une suppression propagée sur tous les appareils, ou une corruption de fichier répliquée avant que tu t’en rendes compte. Une sauvegarde périodique, indépendante du mécanisme de synchronisation, reste indispensable pour un projet de cette ampleur.
Dans l’article précédent, j’ai comparé 5 modèles de langage installés sur un mini PC. Et j’ai réglé la « température » (quel drôle de mot) sur 0.2. Ca m’a fait me demander quelle était l’importance de la température d’un modèle de langage sur la qualité de ses résultats. Et je me suis rendue compte qu’il y a aussi une notion de « system prompt » qui peut avoir une incidence sur la qualité des résultats. Alors j’ai décidé de lancer un test, avec un seul modèle, qui fait varier les températures et le system prompt. Le résultat m’a beaucoup appris sur les modèles de langage.
La température contrôle le degré d’imprévisibilité du texte généré. À chaque mot, le modèle calcule une probabilité pour plusieurs mots suivants possibles. Une température basse (proche de 0) pousse le modèle à toujours choisir le mot le plus probable, ce qui donne des réponses stables et répétitives. Une température plus haute laisse le modèle piocher parmi des mots moins probables, ce qui donne des réponses plus variées et plus créatives, mais aussi plus de risque de dérive ou d’invention.
Le system prompt est une instruction envoyée au modèle avant la conversation elle-même, invisible pour l’utilisateur final. Elle sert à cadrer le comportement du modèle, par exemple « réponds de façon concise » ou « tu es un assistant technique rigoureux ».
Un point important à connaître si tu passes d’une interface comme Open WebUI à un appel direct via l’API d’Ollama : Open WebUI injecte souvent un system prompt par défaut, invisible dans l’interface. Un appel direct à l’API d’Ollama, comme dans le script ci-dessous, n’en contient aucun sauf si tu le précises explicitement dans la requête. C’est une des raisons pour lesquelles un même modèle peut sembler se comporter différemment selon l’interface utilisée.
Le protocole
L’idée : tester Gemma 4 E2B sur le même prompt (logique, traduction, poésie) que dans le comparatif précédent, avec 5 répétitions par configuration, pour distinguer une tendance réelle du simple hasard.
Deux variables testées :
la température : 0,2, 0,5 et 0,8
la présence ou non d’un system prompt de concision
Soit 2 configurations de system prompt x 3 températures x 5 runs, un total de 30 exécutions.
À chaque run, le script exécute docker exec ollama ollama stop gemma4:e2b et attend 2 secondes pour garantir que le modèle est bien déchargé de la mémoire avant de relancer la génération suivante.
#!/bin/bash

MODEL="gemma4:e2b"

PROMPT="Résous ce problème de logique étape par étape : Trois personnes (Alice, Bob et Charlie) ont chacune une couleur de pull différente (Bleu, Rouge, Vert). Alice dit qu'elle ne porte pas de bleu. Charlie porte un pull vert. Quelle est la couleur du pull de Bob ? Ensuite, traduis cette expression anglaise de manière naturelle en français : 'It is raining cats and dogs'. Enfin, écris une seule phrase poétique sur la pluie."

SYSTEM_PROMPT="Tu es un assistant virtuel logique, précis et concis. Analyse les contraintes fournies sans inventer d'éléments extérieurs."

TEMPS=(0.2 0.5 0.8)
RUNS=5
OUTPUT_FILE="resultats_gemma.txt"

echo "=== BENCHMARK GEMMA 4 E2B : STABILITÉ & SYSTEM PROMPT ===" > "$OUTPUT_FILE"
echo "Date : $(date)" >> "$OUTPUT_FILE"
echo "--------------------------------------------------" >> "$OUTPUT_FILE"

# Boucle avec et sans System Prompt
for USE_SYS in "SANS" "AVEC"; do
  for TEMP in "${TEMPS[@]}"; do
    echo "=================================================="
    echo "Configuration : System Prompt [$USE_SYS] | Température [$TEMP]"
    echo "=================================================="
    echo "==================================================" >> "$OUTPUT_FILE"
    echo "CONFIG : System Prompt [$USE_SYS] | Température [$TEMP]" >> "$OUTPUT_FILE"
    echo "==================================================" >> "$OUTPUT_FILE"

    for ((i=1; i<=RUNS; i++)); do
      echo -ne "Exécution $i/$RUNS...\r"

      # Vider la mémoire RAM/VRAM avant chaque run
      docker exec ollama ollama stop "$MODEL" > /dev/null 2>&1
      sleep 2

      # Construction du payload selon la présence du system prompt
      if [ "$USE_SYS" == "AVEC" ]; then
        PAYLOAD=$(jq -n \
          --arg model "$MODEL" \
          --arg prompt "$PROMPT" \
          --arg system "$SYSTEM_PROMPT" \
          --argjson temp "$TEMP" \
          '{model: $model, prompt: $prompt, system: $system, stream: false, options: {temperature: $temp}}')
      else
        PAYLOAD=$(jq -n \
          --arg model "$MODEL" \
          --arg prompt "$PROMPT" \
          --argjson temp "$TEMP" \
          '{model: $model, prompt: $prompt, stream: false, options: {temperature: $temp}}')
      fi

      START_TIME=$(date +%s.%N)
      RESPONSE=$(curl -s http://localhost:11434/api/generate \
        -H "Content-Type: application/json" \
        -d "$PAYLOAD")
      END_TIME=$(date +%s.%N)
      ELAPSED=$(echo "$END_TIME - $START_TIME" | bc)

      TEXT=$(echo "$RESPONSE" | jq -r '.response // "Erreur"')
      EVAL_COUNT=$(echo "$RESPONSE" | jq -r '.eval_count // 0')
      EVAL_DURATION=$(echo "$RESPONSE" | jq -r '.eval_duration // 0')

      if [ "$EVAL_DURATION" -gt 0 ] 2>/dev/null; then
        TPS=$(echo "scale=2; $EVAL_COUNT / ($EVAL_DURATION / 1000000000)" | bc -l)
      else
        TPS="N/A"
      fi

      # Écriture des résultats dans le fichier log
      echo "--- Run $i/$RUNS (${ELAPSED}s | ${TPS} tok/s | ${EVAL_COUNT} tokens) ---" >> "$OUTPUT_FILE"
      echo "$TEXT" >> "$OUTPUT_FILE"
      echo "" >> "$OUTPUT_FILE"
    done

    echo -e "Configuration terminée !          "
  done
done

# Nettoyage final
docker exec ollama ollama stop "$MODEL" > /dev/null 2>&1
echo "=== FIN DU BENCHMARK ==="
echo "Tous les résultats ont été enregistrés dans : $OUTPUT_FILE"
Copie ce script dans un fichier test_gemma.sh, rends-le exécutable (chmod +x test_gemma.sh) et lance-le. Les résultats s’écrivent automatiquement dans resultats_gemma.txt. Compte-toi plusieurs heures d’exécution, 30 runs sur un modèle qui répond en 90 à 110 secondes en moyenne, ça prend du temps.
Une stabilité remarquable sur la logique et la traduction
Sur les 30 exécutions, Gemma 4 E2B obtient un score parfait : 30 sur 30 sur la déduction logique et sur la traduction idiomatique. Même à une température de 0,8, le modèle ne dérive pas et ne se met pas à inventer une couleur ou une traduction fantaisiste.
L’effet du system prompt sur la concision
L’ajout du system prompt de concision change nettement le comportement du modèle :
le nombre moyen de tokens générés passe d’environ 966 (sans) à environ 802 (avec), soit une baisse d’environ 17%
le temps moyen d’exécution passe d’environ 108 secondes à environ 92 secondes par run
sans system prompt, le modèle a tendance à répéter l’énoncé et à ajouter des phrases d’introduction (« Voici la résolution… »), ce que le system prompt supprime
Une vitesse d’inférence constante
Sur l’ensemble des 30 runs, la vitesse brute reste comprise entre 9,80 et 9,87 tokens par seconde, quelle que soit la configuration. Ça confirme que ni la température ni le system prompt ne changent l’effort de calcul par token : ils jouent uniquement sur la longueur et la structure du texte généré.
Et la créativité poétique ?
À température 0,2, les métaphores se répètent beaucoup d’un run à l’autre, la même formulation revient plusieurs fois sur les 5 runs d’une même configuration. À température 0,8, le vocabulaire se diversifie nettement, tout en restant grammaticalement correct.
Ce que je retiens
Gemma 4 E2B se montre robuste sur les tâches factuelles, peu importe la température testée ici. Le vrai levier d’optimisation n’est pas la précision, elle est déjà excellente, mais la vitesse de traitement : ajouter un system prompt de concision réduit le temps de traitement d’environ 17% sans perdre en fiabilité.
Une limite à garder en tête
Ce test ne porte que sur Gemma 4 E2B. Il est possible que d’autres modèles réagissent différemment à un system prompt de concision, ça reste à vérifier avec le même protocole.
J’ai comparé quatre modèles LLM en local dans un premier article, en juin. J’avais réalisé les essais à la main, en ligne de commande. Ici j’ai voulu comparer ces modèles à Gemma 4 E2B, un modèle récent. et j’ai choisi de le faire en automatique, via un script bash. Ma seule contribution pendant le comparatif, c’était de regarder la charge du système avec chaque modèle. J’étais chargée de faire des captures d’écran, le script faisait tout le reste !
La température est un réglage qui contrôle le degré d’imprévisibilité d’un modèle. Une température basse pousse le modèle vers la réponse la plus probable, donc plus stable et plus factuelle. Une température haute laisse plus de place à la variation, ce qui est utile pour la créativité mais augmente le risque d’inventer des éléments qui n’ont pas de sens.
Pour comparer des modèles sur leur capacité à raisonner et traduire correctement, j’ai réglé tous les modèles à une température de 0,2. Par défaut, Open WebUI utilise une température plus élevée (autour de 0,8), pensée pour des usages conversationnels plus créatifs. C’est un choix qui a un impact réel sur les résultats, je détaille cet aspect dans un article, ici, dédié à la température et au system prompt.
Avant de démarrer
Avant tout test, j’ai mis à jour tous mes containers Docker via Portainer (voir l’article dédié), pour être certaine que chaque modèle tourne sur la dernière version d’Ollama.
J’ai aussi arrêté temporairement les containers non essentiels pendant le test (Home Assistant, Tika, Stirling-PDF, Mosquitto, Zigbee2MQTT), pour éviter qu’ils ne consomment de la RAM ou du CPU en arrière-plan et faussent les mesures.
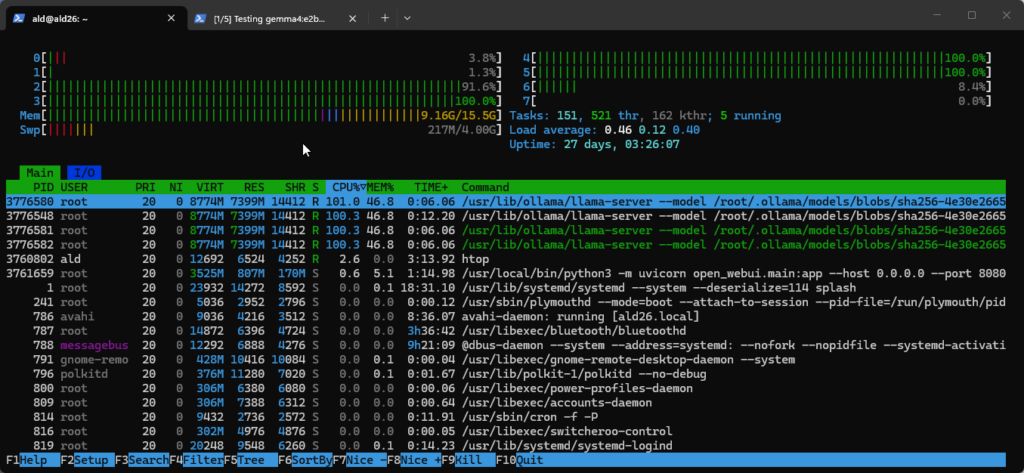
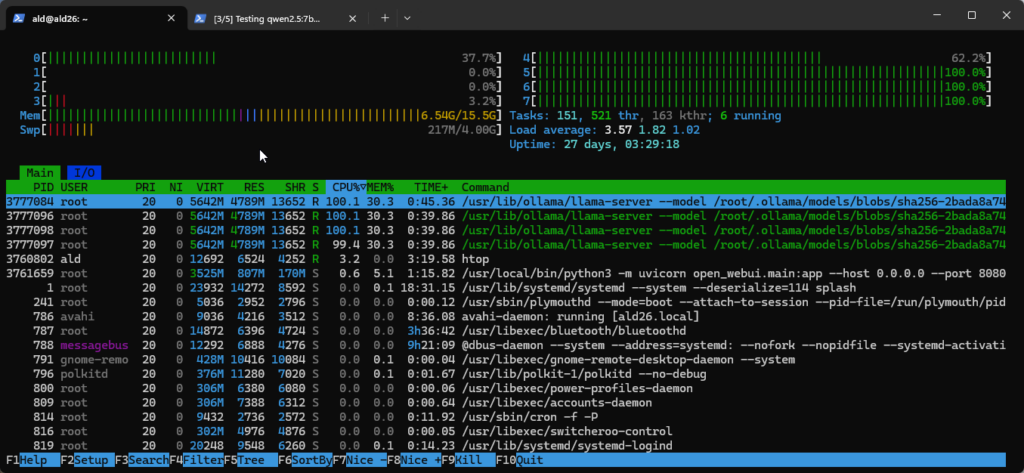
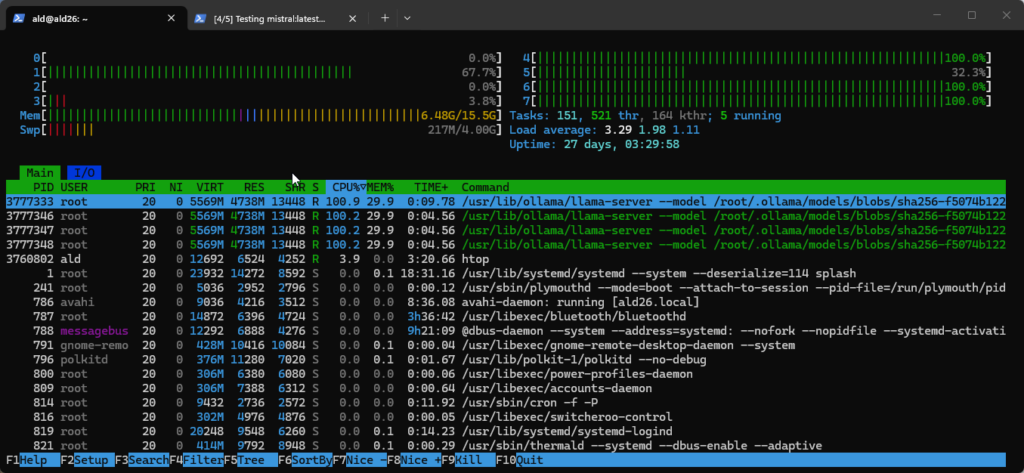
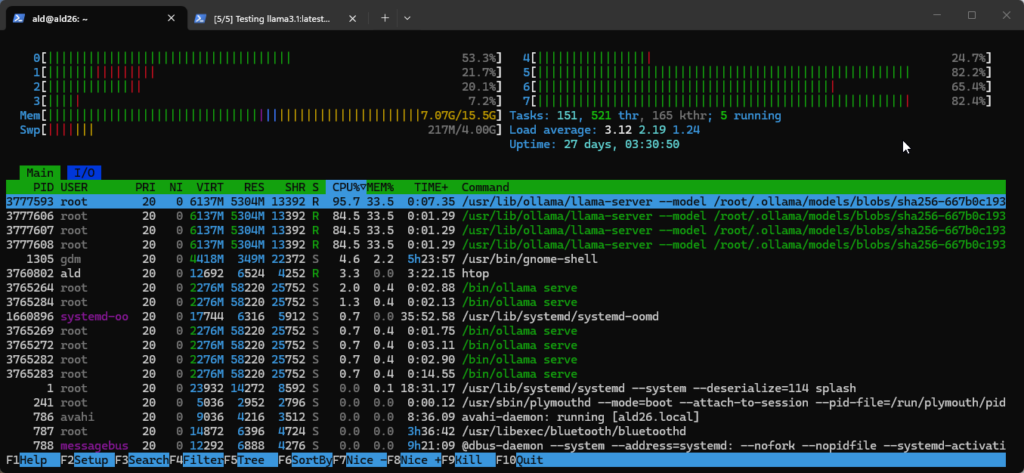
Un second terminal SSH avec htop ouvert en parallèle permet de suivre la consommation de RAM et de CPU pendant chaque test.
Le protocole
Les cinq modèles comparés, tous réglés à température 0,2 :
Gemma 4 E2B
Qwen 2.5 3B
Qwen 2.5 7B
Mistral 7B
Llama 3.1 8B
Chaque modèle reçoit le même prompt, qui combine trois tâches différentes : un problème de logique, une traduction d’expression idiomatique, et une phrase poétique. Ce format permet de juger plusieurs capacités en un seul appel, mais il faut garder en tête qu’un échec sur une tâche ne dit rien des deux autres.
Installe d’abord jq et bc, deux outils utilisés par le script :
bash
sudo apt install jq bc
jq est un processeur JSON en ligne de commande. Comme l’API d’Ollama renvoie ses réponses en JSON, jq sert à en extraire la réponse du modèle, le nombre de tokens générés ou le temps de calcul. bc est une calculatrice en ligne de commande qui gère les nombres à virgule, ce que Bash ne sait pas faire nativement, utile ici pour calculer la vitesse en tokens par seconde.
Crée ensuite le script :
sudo nano /home/USER/benchmark.sh
Colle-y ce contenu :
#!/bin/bash

MODELS=(
  "gemma4:e2b"
  "qwen2.5:3b"
  "qwen2.5:7b"
  "mistral:latest"
  "llama3.1:latest"
)

PROMPT="Résous ce problème de logique étape par étape : Trois personnes (Alice, Bob et Charlie) ont chacune une couleur de pull différente (Bleu, Rouge, Vert). Alice dit qu'elle ne porte pas de bleu. Charlie porte un pull vert. Quelle est la couleur du pull de Bob ? Ensuite, traduis cette expression anglaise de manière naturelle en français : 'It is raining cats and dogs'. Enfin, écris une seule phrase poétique sur la pluie."
JSON_PROMPT=$(jq -rn --arg x "$PROMPT" '$x')

TOTAL=${#MODELS[@]}
INDEX=1

echo "=== DÉBUT DU BENCHMARK ==="
echo "Température : 0.2"
echo "--------------------------------------------------"

for MODEL in "${MODELS[@]}"; do
  # Mise à jour du titre de l'onglet du terminal
  echo -ne "\033]0;[$INDEX/$TOTAL] Pulling $MODEL...\007"
  echo ""
  echo "[$INDEX/$TOTAL] >>> Mise à jour et récupération des infos de : $MODEL"

  # 1. Mise à jour du modèle
  docker exec ollama ollama pull "$MODEL" > /dev/null 2>&1

  # 2. Récupération des informations de version (Digest / Quantization)
  SHOW_INFO=$(curl -s http://localhost:11434/api/show -d "{\"model\": \"$MODEL\"}")
  FAMILY=$(echo "$SHOW_INFO" | jq -r '.details.family // "inconnu"')
  QUANT=$(echo "$SHOW_INFO" | jq -r '.details.quantization_level // "inconnu"')

  # Récupération de l'ID/Digest du modèle via Ollama CLI
  MODEL_ID=$(docker exec ollama ollama list | grep -E "^$(echo $MODEL | cut -d: -f1)" | awk '{print $2}' | head -n 1)

  # 3. Nettoyage VRAM/RAM
  docker exec ollama ollama stop "$MODEL" > /dev/null 2>&1
  sleep 3

  # Mise à jour du titre de l'onglet pendant le test
  echo -ne "\033]0;[$INDEX/$TOTAL] Testing $MODEL...\007"
  echo ">>> Exécution du test..."

  # 4. Envoi de la requête API et mesure
  START_TIME=$(date +%s.%N)

  RESPONSE=$(curl -s http://localhost:11434/api/generate -d "{
    \"model\": \"$MODEL\",
    \"prompt\": $JSON_PROMPT,
    \"options\": {
      \"temperature\": 0.2
    },
    \"stream\": false
  }")

  END_TIME=$(date +%s.%N)
  ELAPSED=$(echo "$END_TIME - $START_TIME" | bc)

  # Extraction des métriques
  TEXT=$(echo "$RESPONSE" | jq -r '.response')
  EVAL_COUNT=$(echo "$RESPONSE" | jq -r '.eval_count')
  EVAL_DURATION=$(echo "$RESPONSE" | jq -r '.eval_duration')

  TPS=$(echo "scale=2; $EVAL_COUNT / ($EVAL_DURATION / 1000000000)" | bc -l 2>/dev/null || echo "N/A")

  # 5. Affichage des résultats
  echo "--------------------------------------------------"
  echo "MODÈLE         : $MODEL"
  echo "ID (Digest)    : ${MODEL_ID:-N/A}"
  echo "Format / Quant : $FAMILY ($QUANT)"
  echo "Temps total    : ${ELAPSED}s"
  echo "Tokens générés : $EVAL_COUNT"
  echo "Vitesse        : ${TPS} tok/s"
  echo "--------------------------------------------------"
  echo "Réponse :"
  echo "$TEXT"
  echo "--------------------------------------------------"

  # Nettoyage
  docker exec ollama ollama stop "$MODEL" > /dev/null 2>&1
  ((INDEX++))
  sleep 2
done

# Remet le titre par défaut du terminal
echo -ne "\033]0;Terminal\007"
echo "=== BENCHMARK TERMINÉ ==="
Rends-le exécutable et lance-le :
sudo chmod +x benchmark.sh
./benchmark.sh
Le script se charge de :
mettre à jour chaque modèle avant de le tester
vider complètement la RAM entre deux modèles, pour ne pas fausser les mesures
envoyer le prompt via l’API d’Ollama avec la température fixée à 0,2
mesurer le temps de réponse total
calculer la vitesse de génération en tokens par seconde
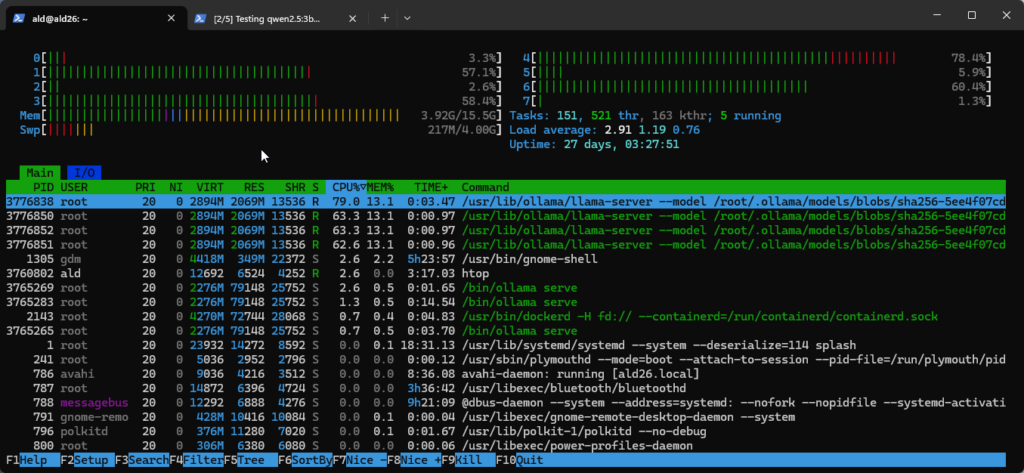
Il n’enregistre en revanche pas les pics de RAM et de CPU du système, c’est pour cela qu’il faut suivre htop en parallèle dans un autre terminal. Voici par exemple une capture d’écran réalisée pendant le test de Gemma 4 E2B. Les 4 autres captures sont tout en bas de l’article :
Résultats
Modèle
Logique
Traduction
Poésie
Vitesse (tok/s)
Temps total
RAM max (htop)
Gemma 4 E2B (5,1B)
Juste (Bleu)
Juste (Cordes)
Juste
9,84
106,78 s
9,16 Go
Qwen 2.5 (3B)
Faux (Rouge)
Faux (hors-sujet)
Juste
8,37
39,63 s
3,92 Go
Qwen 2.5 (7B)
Faux (Rouge)
Juste (Cordes)
Juste
3,78
69,21 s
6,54 Go
Mistral (7B)
Faux (Rouge)
Juste (Cordes)
Juste
3,86
48,92 s
6,48 Go
Llama 3.1 (8B)
Juste (Bleu)
Inexact (« gros traits »)
Juste
3,55
90,98 s
7,07 Go
Gemma 4 E2B est le seul modèle à réussir les trois épreuves sans erreur. Il génère aussi le texte le plus rapidement en tokens par seconde, même si son temps total reste élevé à cause d’une phase de réflexion plus longue avant de produire la réponse. Sa consommation RAM est la plus élevée du lot, ce qui s’explique par le contexte de raisonnement chargé en mémoire.
Les deux modèles Qwen 2.5 7B et Mistral 7B échouent tous les deux sur le problème de logique, en concluant à tort que Bob porte du rouge. Llama 3.1 8B résout correctement la logique mais traduit l’expression de façon moins idiomatique.
Au vu de ces résultats, Gemma 4 E2B devient mon modèle local par défaut. Il n’est pas seulement le plus fiable des cinq sur ce test, c’est aussi le seul de la sélection à traiter nativement le texte, l’image et l’audio. Il peut aussi analyser des vidéos, en les découpant en une séquence d’images.
Cette capacité multimodale ouvre des usages que je n’avais pas avec les autres modèles testés ici, comme la transcription ou la description d’images directement en local. C’est une piste que je compte explorer dans un prochain article. Et je vais aussi l’utiliser comme une sorte d’agent.
Pour aller plus loin
Cet article fait partie de la série Créer une IA locale. Retrouve aussi la série Projets Ubuntu pour tout ce qui touche à l’infrastructure Linux qui héberge ces modèles.
Les copies d’ecran htop pendant les 4 autres essais
Je voulais mettre à jour mes containers Docker avant de lancer une expérmentation. Je ne me suis pas vraiment posé de question, j’ai moins d’une dizaine de containers. J’ai choisi une méthode manuelle, via Portainer, sans perdre leur configuration.
La mise à jour manuelle via Portainer présente trois avantages :
tu choisis exactement quand la coupure de service a lieu
tu vois immédiatement dans les logs si le container redémarre correctement
tu n’ajoutes pas de container supplémentaire qui tourne en permanence
La méthode
Pour chaque container à mettre à jour, sans perdre sa configuration ni ses données (à condition qu’elles soient stockées sur des volumes ou des dossiers hôtes) :
Dans Portainer, va dans Containers et clique sur le container concerné.
Clique sur Re-create (ou Duplicate/Edit selon la version de Portainer) dans la barre d’outils.
Active l’interrupteur Pull latest image.
Valide en cliquant sur Re-create.
Portainer va chercher la nouvelle version de l’image sur Docker Hub, arrête l’ancien container et en relance un nouveau avec les mêmes variables d’environnement, ports et volumes.
Vérifier que la mise à jour s’est bien passée
Une fois le container recréé, vérifie dans Portainer :
que le statut passe bien à running
que les logs du container ne montrent pas d’erreur au démarrage
que le service reste accessible (par exemple, l’interface web du container si elle existe)
Si un container refuse de redémarrer après une mise à jour, la cause la plus fréquente est une incompatibilité entre la nouvelle version de l’image et la configuration existante (variable d’environnement renommée, changement de format de volume, etc.). Dans ce cas, les logs Portainer donnent en général une indication claire du problème.
Pour aller plus loin
Cet article fait partie de la série Projets Ubuntu, qui documente la gestion d’une infrastructure Linux personnelle.

Commentaires récents