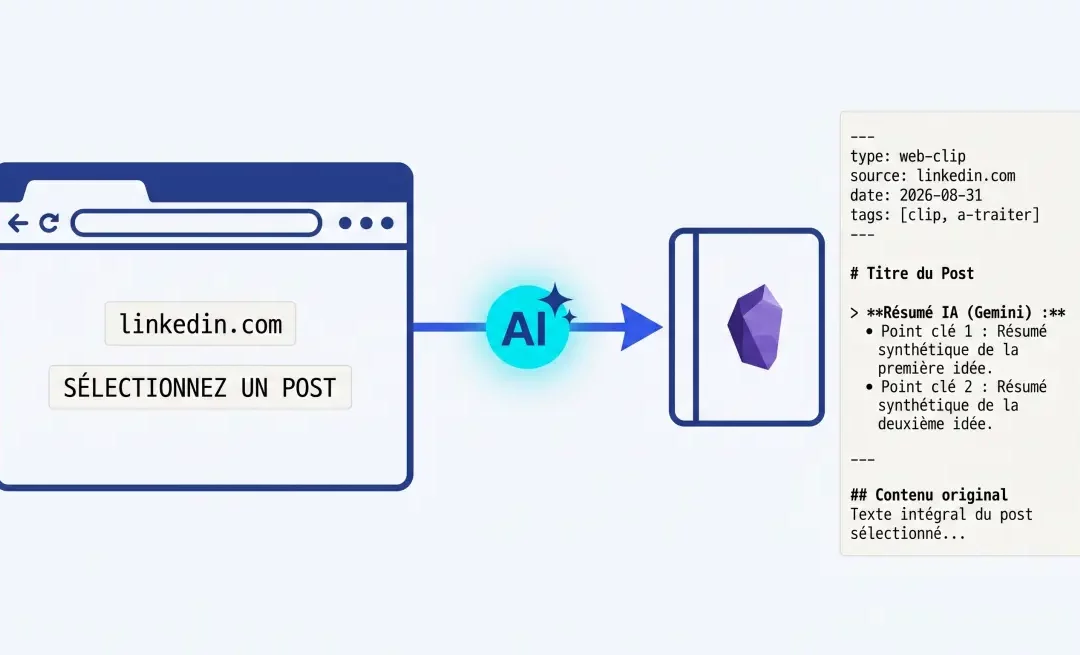
Je voulais capturer des posts LinkedIn intéressants directement dans Obsidian, avec un résumé automatique, sans écrire une ligne de code moi-même. Cet article documente comment j’ai construit cette extension Chrome avec Antigravity, un agent de développement piloté par IA, et l’API Gemini de Google.
Antigravity et les extensions Chrome, en bref
Antigravity est un environnement de développement piloté par un modèle d’IA (Gemini, l’IA de Google). Tu lui donnes des instructions en langage naturel, appelées prompts, et il écrit et modifie les fichiers de code à ta place, dans un dossier sur ton ordinateur.
Une extension Chrome est un petit programme qui s’ajoute au navigateur pour lui donner une fonctionnalité supplémentaire. Depuis 2024, Google impose que toute nouvelle extension respecte un format appelé Manifest V3 (MV3) : un fichier manifest.json qui décrit les permissions demandées et le comportement de l’extension. MV3 impose des règles de sécurité strictes, par exemple limiter les sites sur lesquels l’extension peut agir.
Gemini intervient à trois niveaux distincts dans ce projet, à ne pas confondre :
Gemini en tant que chat : c’est l’interface conversationnelle utilisée en amont, pour discuter du besoin, découper le projet en étapes et rédiger les prompts destinés à Antigravity.
Gemini en tant qu’API : appelée par Antigravity pour concevoir l’application souhaitée. C’est aussi le service que le code de l’extension appelle directement (à l’étape 3), pour générer le résumé du texte capturé.
Une API (interface de programmation) est le canal standardisé par lequel un programme demande un service à un autre.
Le projet : « Web Clipper to Obsidian »
L’objectif : cliquer sur l’icône de l’extension pendant que je consulte une page web, en particulier un post LinkedIn, et obtenir automatiquement dans Obsidian une note contenant :
le texte sélectionné (ou le texte principal de la page si rien n’est sélectionné)
l’image du post
un résumé généré par l’IA Gemini
l’URL source et la date de capture
Obsidian est un logiciel de prise de notes qui stocke tout en fichiers Markdown. Il peut recevoir des notes depuis l’extérieur via un protocole appelé obsidian://, un lien spécial qui, une fois activé, ouvre directement l’application avec le contenu fourni.
Prérequis
Antigravity installé (téléchargement sur antigravity.google/download, connexion avec un compte Google)
Obsidian installé (téléchargement sur obsidian.md), avec un coffre (vault) existant
Une clé API Gemini, avec une alerte de budget configurée (voir plus bas)
Une remarque sur la méthode
Plutôt que de demander à Antigravity de générer l’extension complète en une seule fois, le projet a été découpé en quatre étapes, chacune ajoutant une seule fonctionnalité testable. Cadrer le besoin puis avancer par petites briques validées une à une est une méthode de travail à part entière, détaillée dans un article dédié sur parcours-performance.com (lien ajouté prochainement).
Étape 1 : squelette fonctionnel
Objectif : au clic sur l’icône de l’extension, ouvrir une note de test dans Obsidian, pour valider que la liaison entre Chrome et Obsidian fonctionne.
Prompt donné à Antigravity :
Role: Expert Chrome Extension Developer (Manifest V3)

Context:
Nous démarrons le développement d'une extension Google Chrome nommée "Web Clipper to Obsidian". Ce projet suit une approche itérative en 4 étapes. Nous exécutons actuellement l'Étape 1 (POC / Squelette fonctionnel).

Objectif de l'Étape 1:
Créer le squelette de l'extension. Lors d'un clic sur l'icône de l'extension, l'application doit immédiatement ouvrir une nouvelle note dans Obsidian via le protocole natif `obsidian://new` avec un contenu de test statique, pour valider la chaîne de liaison.

Consignes d'architecture et de sécurité:
1. Utilise impérativement Manifest V3.
2. Applique le principe du moindre privilège : demande uniquement les permissions nécessaires pour cette étape. Ne pas utiliser `<all_urls>`.
3. Utilise l'action de clic directe (`chrome.action.onClicked`) sans afficher de pop-up HTML pour le moment, afin de garantir une expérience zéro-clic.
4. Assure-toi que les titres de fichiers sont "sanitisés" (suppression/remplacement des caractères interdits par les systèmes de fichiers comme `/ \ : * ? " < > |`).

Format de la note de test générée dans Obsidian:
- Titre : "Test Clip - [Date du jour]"
- Vault par défaut : "MonVault" (variable à rendre facilement modifiable au début du code)
- Contenu Markdown :
  ---
  type: web-clip-test
  date: [Date du jour]
  ---
  # Test de connexion réussit !
  Ceci est un clip de test généré depuis mon extension Chrome.

Livrables attendus :
1. Génère les fichiers nécessaires pour que l'extension soit directement chargeable dans Chrome via "Charger l'extension non empaquetée".
2. Donne de courtes instructions pour tester l'extension dans Chrome et Obsidian.
POC est l’abréviation de « proof of concept » (preuve de concept) : une version minimale qui sert uniquement à vérifier qu’une idée fonctionne techniquement, avant d’y ajouter des fonctionnalités.
Comme demandé dans le prompt (« donne de courtes instructions pour tester »), Antigravity a lui-même fourni la marche à suivre pour essayer ce qu’il venait de produire. Ça fonctionne dès le premier essai.
À noter : le prompt demande de nettoyer les titres de fichiers en remplaçant les caractères interdits par un système de fichiers (/ \ : * ? " < > |) par des tirets. Ce nettoyage, parfois appelé « sanitisation » (un anglicisme calqué sur « sanitize« ), ne couvre à ce stade que ces caractères interdits, pas les accents. Cette limite se révélera plus loin, quand un titre accentué produira un nom de fichier posant problème : le nettoyage sera alors complété pour gérer aussi ce cas.
Étape 2 : extraction du contenu de la page
Objectif : rendre l’extension capable de lire le titre, l’URL et le texte sélectionné (ou à défaut le texte principal) de la page web active.
Prompt donné à Antigravity :
Role: Expert Chrome Extension Developer (Manifest V3)

Context:
L'Étape 1 est validée avec succès : l'extension parvient à ouvrir Obsidian et à y créer une note de test via `obsidian://new`. Nous passons à l'Étape 2.

Objectif de l'Étape 2:
Capturer dynamiquement les informations de la page web active (`activeTab`) lors du clic sur l'icône de l'extension et les transmettre à la note Obsidian.

Spécifications techniques :
1. Mise à jour de Manifest V3 :
   - Conserver les règles de sécurité strictes (pas de `<all_urls>`).
   - Ajouter la permission `scripting` si nécessaire pour exécuter un Content Script éphémère sur l'onglet actif.
2. Logique d'extraction (Content Script) :
   - Récupérer le titre de la page (`document.title`).
   - Récupérer l'URL exacte de la page (`window.location.href`).
   - Récupérer le texte sélectionné par l'utilisateur à la souris (`window.getSelection().toString()`).
   - SI aucun texte n'est sélectionné : récupérer le texte principal de la page ou du post (fallback).
3. Traitement et sécurité des données :
   - Nettoyer le titre pour le nom du fichier Markdown (remplacer les caractères interdits `/ \ : * ? " < > |` par des tirets).
4. Formatage de la note Obsidian générée :
   ---
   type: web-clip
   source_url: "[URL_DE_LA_PAGE]"
   date_capture: [Date du jour YYYY-MM-DD]
   tags: [clip, a-traiter]
   ---
   # [TITRE_DE_LA_PAGE]

   ## Contenu extrait
   [TEXTE_SELECTIONNE_OU_EXTRAIT]

Livrables attendus :
Met à jour le code de l'extension et indique-moi quand effectuer le rechargement dans `chrome://extensions` pour tester l'extraction sur une vraie page web (ou un post LinkedIn).
Un Content Script est un petit programme que l’extension injecte temporairement dans la page web visitée, pour pouvoir en lire le contenu.
À noter : à ce stade, aucune IA n’intervient. Il s’agit de programmation classique, qui va chercher dans la page (le DOM, la structure de la page web) le titre, l’URL et le texte sélectionné. L’IA n’entrera en jeu qu’à l’étape 3, pour interpréter ce contenu.
Après chaque modification du code par Antigravity, l’extension doit être rechargée avant de pouvoir tester la nouvelle version : sur chrome://extensions, cliquer sur l’icône de rafraîchissement (flèche circulaire) de la fiche de l’extension. Sans ce rechargement, Chrome continue de faire tourner l’ancienne version du code.
Obtenir et sécuriser une clé API Gemini
Avant l’étape 3, il faut une clé API Gemini. Une clé API est un identifiant unique qui permet à un programme d’utiliser un service en ligne (payant à l’usage ou pas), ici l’IA Gemini de Google.
Pour l’obtenir :
Va sur aistudio.google.com et connecte-toi avec ton compte Google.
Accepte les conditions d’utilisation si c’est ta première visite.
Clique sur « Get API key » (Obtenir une clé API), puis sur « Créer une clé API ».
Choisis « Créer une clé dans un nouveau projet », donne-lui un nom.
Copie la clé générée et garde-la confidentielle : ne la partage nulle part, ne la mets jamais en clair dans du code que tu publies.
Le tarif de l’API Gemini dépend du volume de requêtes. Pour un usage personnel, le risque principal n’est pas le montant en lui-même mais une dérive non surveillée, par exemple un bug qui déclenche des appels en boucle. Deux précautions simples permettent de s’en prémunir :
Utiliser un moyen de paiement à plafond limité. Associer le compte de facturation Google Cloud à une carte dont les dépenses ne peuvent pas dépasser le solde disponible (une carte de type Nickel, par exemple), plutôt qu’à une carte bancaire classique adossée à un compte principal.
Configurer une alerte de budget dans Google Cloud. La marche à suivre :
Va sur console.cloud.google.com, connecté avec le compte Google concerné.
Sélectionne le projet créé pour l’API Gemini dans le sélecteur de projet en haut de l’écran.
Dans le menu de gauche ou la barre de recherche, cherche « Facturation », puis la section « Budgets et alertes ».
Clique sur « Créer un budget ».
Donne un nom au budget (par exemple alerte-budget-api).
Vérifie que le champ d’application est limité au projet courant.
Renseigne un montant très bas, par exemple 1 €.
Conserve les seuils d’alerte proposés par défaut (50 %, 90 % et 100 % du montant) : avec un budget aussi bas, ils suffisent largement à prévenir dès la moindre dépense.
Enregistre.
Ces deux précautions prises, la clé peut être utilisée dans l’extension.
Étape 3 : connexion à l’API Gemini
Objectif : envoyer le texte extrait à l’API Gemini pour générer un résumé, et l’intégrer dans la note Obsidian.
Prompt donné à Antigravity :
Role: Expert Chrome Extension Developer (Manifest V3)

Context:
L'Étape 2 est validée avec succès : l'extension extrait le texte, l'URL et le titre, et crée la note dans Obsidian. Nous passons à l'Étape 3 : l'intégration de l'API Google Gemini.

Ajustement obligatoire :
- Fixe le nom du Vault Obsidian par défaut sur : "MonVault".

Objectif de l'Étape 3:
Envoyer le texte extrait à l'API Google Gemini pour générer un résumé synthétique du contenu, puis intégrer ce résumé dans la note Obsidian.

Spécifications techniques :
1. Clé API Gemini (Provisoire pour le test) :
   - Ajoute une variable de configuration explicite `const GEMINI_API_KEY = "TA_CLE_API_ICI";` dans le script de background.
   - Prévois une vérification : si la clé vaut "TA_CLE_API_ICI", l'extension doit sauter l'étape IA et créer la note directement comme à l'Étape 2 (fallback sécurisé).
2. Appel à l'API Gemini :
   - Endpoint : API REST Gemini.
   - Prompt système pour Gemini :
     "Tu es un assistant de prise de notes. Analyse le texte suivant extrait d'une page web/LinkedIn. Génère un résumé clair et concis en 2 à 3 puces grand maximum. Réponds UNIQUEMENT avec le résumé au format Markdown."
3. Formatage final de la note Obsidian :
   ---
   type: web-clip
   source_url: "[URL_DE_LA_PAGE]"
   date_capture: [Date du jour YYYY-MM-DD]
   tags: [clip, résumé-ia, a-traiter]
   ---
   # [TITRE_DE_LA_PAGE]

   > **Résumé IA (Gemini) :**
   > [RÉSUMÉ_GÉNÉRÉ_PAR_GEMINI]

   ---

   ## Contenu original extrait
   [TEXTE_EXTRAIT]
4. Feedback visuel (UX) :
   - Pendant que l'API Gemini répond, change temporairement le badge de l'icône de l'extension pour indiquer à l'utilisateur que l'IA travaille.

Livrables attendus :
Mets à jour le code de l'extension et explique-moi où coller ma clé API Gemini pour tester l'Étape 3.
API est l’abréviation d' »application programming interface » (interface de programmation) : le canal standardisé par lequel un programme peut demander un service à un autre. REST est un style d’architecture couramment utilisé pour ces API, où chaque requête s’envoie par une URL. UX est l’abréviation d' »user experience » (expérience utilisateur) : la façon dont l’usage du produit se ressent concrètement.
À noter : ce prompt contient un prompt dans le prompt. Le texte donné à Antigravity (« Tu es un assistant de prise de notes… ») n’est pas une instruction pour Antigravity lui-même : c’est le texte que le code, une fois écrit, enverra à son tour à l’API Gemini à chaque clip. Antigravity ne l’exécute pas, il l’intègre tel quel dans le code qu’il génère.
Suivre et corriger les erreurs
Cette étape n’a pas fonctionné du premier coup. L’API a d’abord renvoyé une erreur 404 (ressource introuvable), le nom du modèle Gemini demandé par le code n’étant plus valide. Google fait évoluer régulièrement les noms de modèles disponibles, ce qui rend ce type d’erreur fréquent avec une IA en développement rapide.
Pour diagnostiquer ce genre de problème, la console de développement de Chrome est l’outil de référence :
Va sur chrome://extensions.
Sur la fiche de l’extension, clique sur le lien « Service Worker » sous « Inspecter les vues ».
Dans la fenêtre qui s’ouvre, clique sur l’onglet « Console ».
Relance un clip depuis une page web : le message d’erreur exact s’affiche en rouge.
Plusieurs allers-retours ont été nécessaires pour corriger le nom du modèle. Mais le vrai point de bascule est venu d’une relecture attentive du code généré : une clé API par défaut factice s’y trouvait dupliquée à deux endroits différents (background.js et options.js), ce qui masquait silencieusement le vrai problème en remplaçant une clé vide par une fausse valeur plutôt que de signaler l’erreur. Un agent de code peut corriger un symptôme sans traiter la cause, si on ne le questionne pas sur la cohérence d’ensemble.
Deux réflexes utiles face à une erreur qui persiste : relire soi-même le code généré, dans la mesure de ses compétences, pour repérer les incohérences visibles (doublons, valeurs codées en dur, logique redondante) ; et, si la lecture directe du code n’est pas possible, le transmettre à un chat comme Gemini en lui demandant explicitement s’il identifie une cause aux erreurs rencontrées. L’agent de code qui a écrit le programme n’est pas toujours le mieux placé pour en questionner la cohérence d’ensemble.
Une fois le code nettoyé et le nom du modèle corrigé, le résumé Gemini s’est généré correctement à chaque test.
Étape 4 : sécurisation et finitions
Objectif : sortir la clé API et le nom du vault du code source pour les placer dans une page d’options dédiée, et ajouter un retour visuel pendant le traitement.
Cette étape n’est pas un simple confort : une clé API ou un nom de vault codés « en dur » dans les fichiers JavaScript se retrouvent visibles dès qu’on partage le code, qu’on le publie, ou qu’on l’inspecte via les outils de développement de Chrome. Toute valeur confidentielle ou spécifique à un utilisateur doit être stockée séparément, jamais écrite directement dans le code source.
Prompt donné à Antigravity :
Role: Expert Chrome Extension Developer (Manifest V3)

Context:
L'Étape 3 est un succès total (extraction texte + image + résumé Gemini + export Obsidian sans erreur).
Nous passons à l'Étape 4 : la sécurisation des paramètres et les finitions UX.

Objectifs de l'Étape 4 :
1. Déplacer la clé API Gemini et le nom du Vault Obsidian dans une page d'options dédiée.
2. Ajouter des indicateurs visuels d'état sur l'icône de l'extension.

Spécifications techniques :

1. Page d'options Chrome (`options.html` + `options.js`) :
   - Crée une page de paramètres accessible via un Clic Droit sur l'icône de l'extension -> "Options".
   - Propose deux champs de saisie :
     a. Clé API Gemini (type `password` pour la masquer).
     b. Nom du Vault Obsidian (valeur par défaut : "MonVault").
   - Utilise le stockage de l'extension pour enregistrer et charger ces paramètres.
   - Mets à jour `background.js` pour qu'il récupère la clé et le vault depuis ce stockage avant de lancer la requête.
   - Si la clé est manquante lors d'un clic, ouvre automatiquement la page d'options.

2. Feedback visuel (UX) :
   - Au moment du clic : affiche un badge bleu "..." sur l'icône de l'extension.
   - Une fois la note créée : affiche un badge vert "OK" pendant 2 secondes, puis efface-le.
   - En cas d'erreur : affiche un badge rouge "ERR" pendant 3 secondes.

Mets à jour le projet et indique-moi quand effectuer le rechargement final dans Chrome.
Pour configurer : recharger l’extension, clic droit sur son icône, « Options », saisir la clé API et le nom du vault, enregistrer. Au clip suivant, le badge bleu s’affiche pendant le traitement, puis un badge vert confirme la création de la note dans Obsidian.
État actuel et limites connues
La capture de l’image du post reste peu fiable lorsqu’elle se fait depuis le fil d’actualité LinkedIn (l’extension récupère parfois l’image d’un post voisin dans le flux), alors qu’elle fonctionne correctement depuis la page dédiée à un post précis. Une phase d’amélioration est prévue pour affiner ce point, ainsi que pour étendre l’extension à d’autres sites que LinkedIn.
Bilan
Quatre prompts structurés, quelques allers-retours de débogage guidés par la console Chrome, et une extension fonctionnelle capable de capturer du texte et une image, de les faire résumer par une IA, et de créer une note Obsidian prête à l’emploi, sans écrire une ligne de code à la main. La méthode de découpage en étapes testables et de rédaction des prompts est reprise en détail dans un article dédié sur parcours-performance.com (lien à indiquer).
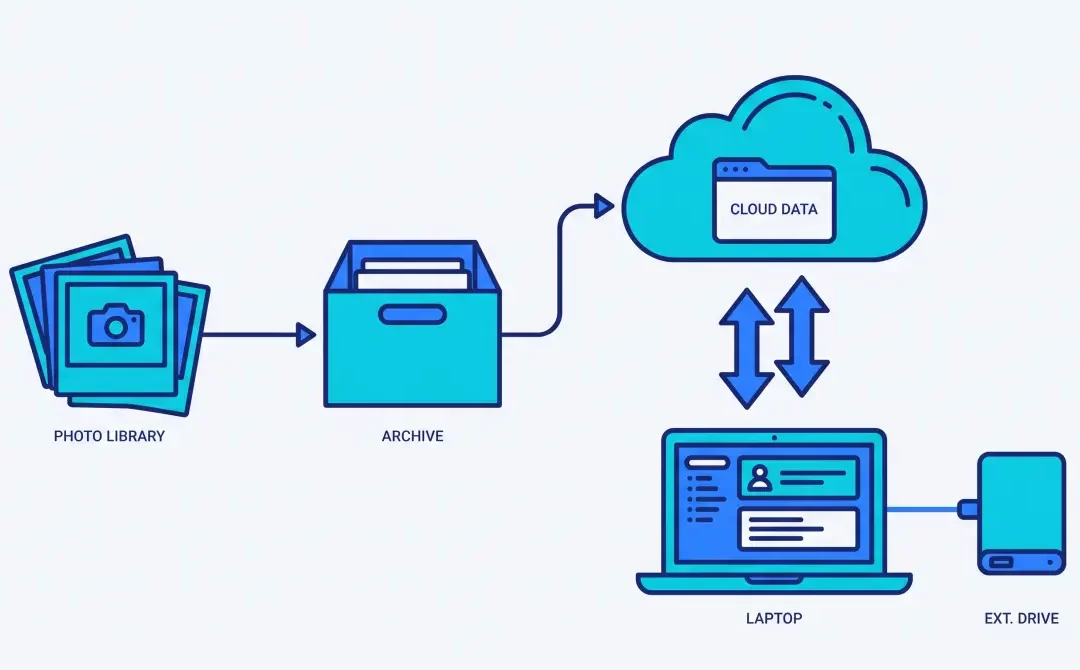
Ta bibliothèque de photos est probablement synchronisée sur Google Photos, sans autre copie. En cas de perte de compte, piratage ou suspension, cette bibliothèque disparaît. Voici comment en récupérer une copie indépendante grâce à Google Takeout, jusqu’à un disque local.
Pourquoi Google Takeout, et pas rclone directement
Depuis fin mars 2025, l’API que rclone utilise pour Google Photos a été restreinte par Google : rclone ne peut plus télécharger que les photos qu’il a lui-même envoyées, pas l’ensemble d’une bibliothèque déjà existante. rclone n’est donc plus une option pour extraire directement tes photos. Google Takeout reste la méthode recommandée pour un export complet, avec les métadonnées d’origine.
Étape 1 : créer l’export avec Google Takeout
Dans les paramètres de ton compte Google Photos, va dans Exporter vos données > Sauvegarder
Crée une exportation, choisis ce que tu veux sauvegarder (l’ensemble de ta bibliothèque par exemple)
Vérifie la destination : par défaut, Google Takeout propose d’envoyer un lien de téléchargement par e-mail. Remplace cette destination par Envoyer à Drive. Il y a d’autres options, pas pertinentes pour moi : Dropbox, OneDrive, Box). Nextcloud n’est pas proposé.
Choisis « Exporter une fois », format .zip, taille de fichier 2 Go
Clique sur « Créer une exportation »
Attends l’e-mail de fin de traitement, le délai peut aller jusqu’à plusieurs heures selon le volume de ta bibliothèque
Étape 2 : récupérer l’export dans un dossier Google Drive dédié
L’export atterrit dans un dossier Takeout créé automatiquement par Google, mélangé au reste de ton Drive. Mieux vaut le déplacer dans un dossier dédié avant de passer à la suite :
Ouvre Google Drive, dossier Takeout. Il est à la racine de « Mon Drive »
Déplace ce dossier Takeout là où ça te semble pertinent
Étape 3 : synchroniser ce dossier avec un disque local
Google Photos et Google Drive sont deux services Google distincts : un problème sur l’un (compte Photos suspendu, par exemple) n’affecte pas nécessairement l’autre. Mais pour être vraiment protégé, il faut une copie qui sorte de l’écosystème Google, sur un support que tu maîtrises entièrement.
La méthode la plus simple : installer le client de synchronisation Google Drive sur ton PC (Windows ou macOS), et le laisser synchroniser ce dossier dédié vers un dossier local sur ton disque dur. Une fois la synchronisation terminée, tu disposes d’une copie physique de tes photos sur ta machine, indépendante de toute connexion internet ou de la disponibilité de Google Photos.
Ce qui reste à faire
Cette copie locale reste, pour l’instant, sur le même PC que celui utilisé au quotidien pour accéder à Google Drive. Une indépendance complète de l’écosystème Google viendra d’une copie supplémentaire sur un support totalement déconnecté : disque dur externe débranché en dehors des sauvegardes, ou gravure sur DVD pour un archivage à très long terme. Cette étape suivante n’est pas encore réalisée à l’heure où j’écris cet article, elle fera l’objet d’un complément le moment venu.
Conclusion
En cas de problème sur Google Photos, tant que Google Drive reste accessible, la bibliothèque de photos existe encore, à cet endroit précis. Et depuis l’étape de synchronisation locale, elle existe aussi sur le disque dur du PC, sans dépendre de la disponibilité d’aucun service Google. C’est un exemple concret du principe décrit dans Les limites cachées des solutions cloud : le cloud seul ne suffit jamais, une copie locale reste le seul vrai filet de sécurité.
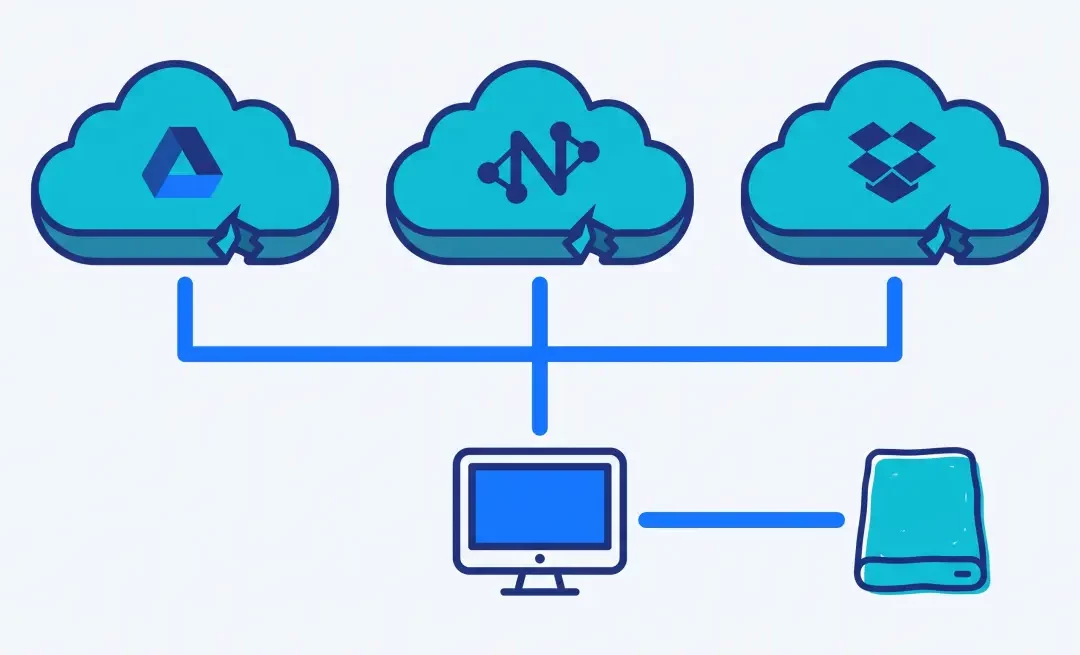
Le cloud donne une impression de capacité illimitée, où il suffirait de lancer une commande pour que tout se transfère sans effort. La réalité est bien différente. Aucune solution n’est parfaite. Voici trois limites rencontrées sur trois services différents (Dropbox, Google Drive, Nextcloud), et la conclusion qui en découle : ne jamais dépendre uniquement du cloud pour tes données importantes.
Cet article fait partie de la série Projets Ubuntu, consacrée à mon Mini PC sous Ubuntu et son infrastructure Docker.
Dropbox : une API très sensible à la concurrence
En migrant plusieurs dizaines de milliers de fichiers Dropbox vers Google Drive avec rclone, le débit s’est effondré à quelques centaines de kilo-octets par seconde, alors que la connexion utilisée tenait sans problème plusieurs centaines de mégabits. La cause : l’API Dropbox tolère très mal un grand nombre de requêtes simultanées sur de nombreux petits fichiers, contrairement à Google Drive qui encaisse ce type de charge sans broncher. La solution qui a fonctionné : synchroniser d’abord Dropbox sur un disque local avec le client de bureau habituel, puis transférer ce disque vers Google Drive avec rclone, sans jamais repasser par l’API Dropbox pour ce volume de fichiers.
Google Drive : un quota de requêtes partagé par défaut
Sans configuration particulière, rclone se connecte à Google Drive avec un identifiant d’application qui lui est propre, partagé par tous les utilisateurs de rclone dans le monde qui n’ont pas configuré leurs propres identifiants. Le quota de requêtes par minute de cet identifiant partagé peut donc être atteint à cause de l’usage d’autres personnes, totalement indépendamment du volume que tu transfères toi-même. Ça se traduit par une erreur de ce type, sans rapport apparent avec ce que tu es en train de faire :
RATE_LIMIT_EXCEEDED
La solution : créer son propre projet Google Cloud, avec ses propres identifiants OAuth, pour disposer d’un quota qui n’appartient qu’à toi et non plus partagé avec le reste du monde. La démarche complète (création du projet, activation de l’API, génération des identifiants, reconfiguration de rclone) fait l’objet d’un article dédié, à paraître.
Nextcloud : une limite structurelle sur les gros fichiers via WebDAV
Cette troisième limite est la plus difficile à diagnostiquer, parce qu’elle ne vient ni d’un quota, ni d’une mauvaise configuration, mais d’un bug connu et documenté du protocole utilisé.
Le contexte : transférer un export Google Photos (Google Takeout) depuis Google Drive vers un espace Nextcloud, avec des fichiers ZIP d’environ 2 Go chacun. Commande de départ :
Le fichier temporaire créé par Nextcloud pendant l’envoi (.upload.part) reste verrouillé, rclone considère alors le transfert comme échoué et redémarre l’envoi du fichier entier depuis zéro. Résultat : plus d’une heure passée à recommencer plusieurs fois le même fichier de 2 Go, sans jamais aboutir.
Deux pistes ont été testées avant de trouver la vraie cause :
Mettre à jour rclone vers une version récente, pour bénéficier du découpage automatique des gros fichiers en petits blocs (chunking) lors de l’envoi vers Nextcloud, une fonctionnalité absente des versions plus anciennes
Ajuster la taille de ces blocs avec l’option --webdav-nextcloud-chunk-size, en restant sous la limite d’upload fixée par l’hébergeur (visible dans les paramètres PHP, « Taille maximum d’un fichier pour l’envoi »)
Aucune des deux n’a résolu le problème de fond : même avec une version récente et des blocs correctement dimensionnés, le même verrou 423 Locked est réapparu lors de l’assemblage final des blocs côté serveur. En creusant du côté des tickets techniques du projet rclone, la cause est confirmée par les développeurs eux-mêmes : il n’existe aucun moyen fiable de vérifier si cet assemblage, effectué côté serveur Nextcloud, est encore en cours ou a échoué. Si l’assemblage prend un peu de temps, ce qui est normal pour un gros fichier, rclone peut l’interpréter comme un échec et relancer tout l’envoi. C’est un problème ouvert depuis plusieurs années, qui touche spécifiquement les gros fichiers envoyés à un serveur Nextcloud via le protocole WebDAV.
Autrement dit : ni une mauvaise configuration, ni une version obsolète, mais une limite structurelle qui touche cette combinaison précise d’outil et de protocole, pour ce type de fichier volumineux. La règle qui en découle : garder les fichiers sous 500 Mo à 1 Go pour un envoi vers Nextcloud, avec --transfers 1, et désactiver le découpage en blocs quand le fichier tient dans la limite d’upload de l’hébergeur. Pour les fichiers plus gros, comme un export Google Takeout, une autre méthode est nécessaire, elle fait l’objet d’un article dédié.
La conclusion commune : le cloud ne remplace jamais une sauvegarde locale
Ces trois limites n’ont techniquement rien en commun : une API sensible à la charge, un quota partagé par défaut, un bug de verrouillage sur un protocole de transfert. Mais elles partagent le même enseignement : aucune automatisation cloud à cloud n’est garantie de bout en bout. Un transfert peut caler à mi-chemin, pour une raison qui n’a parfois rien à voir avec la taille des données ou la qualité de la connexion.
C’est pour ça qu’une copie locale, sur un disque que tu maîtrises entièrement, reste indispensable en complément de toute sauvegarde cloud. Pas comme solution de confort, mais comme filet de sécurité pour le jour où un transfert automatisé n’ira pas au bout, ou pour le jour où il faudra tout simplement sortir d’un service cloud, avec ou sans sa coopération.
J’ai perdu l’outil de capture d’écran que j’utilisais jusqu’ici, pratique au quotidien. Je me suis tournée vers ShareX, un logiciel gratuit et open source pour Windows, riche en fonctionnalités.
Pourquoi ShareX
ShareX permet de capturer une zone d’écran, de l’annoter directement, puis de la copier ou de l’enregistrer. Il propose beaucoup plus de possibilités qu’un simple outil de capture basique, notamment un éditeur d’annotation complet. Voir toutes les possibilités sur le site : https://getsharex.com/
Le raccourci de capture
J’utilise le raccourci prédéfini Ctrl + Impr écran pour lancer une capture de zone.
Configurer les tâches après la capture
Par défaut, ShareX propose plusieurs actions automatiques une fois la capture réalisée. Dans le menu « Tâches après la capture », seules « Copier l’image dans le presse-papier » et « Enregistrer l’image comme fichier » étaient cochées.
J’ai ajouté l’option « Afficher le menu des tâches rapides ». Elle ouvre l’éditeur d’annotation juste après la capture, avant toute copie ou sauvegarde. Cela permet d’annoter l’image immédiatement, ce qui est très utile pour expliquer une manipulation ou pointer un élément précis à l’écran.
Les outils d’annotation
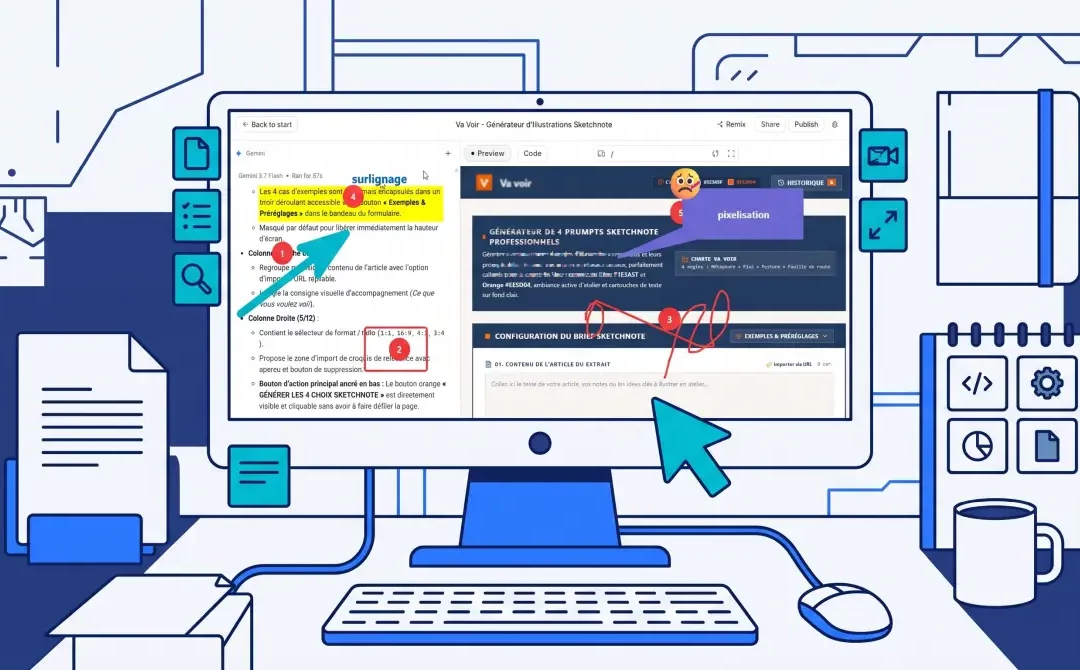
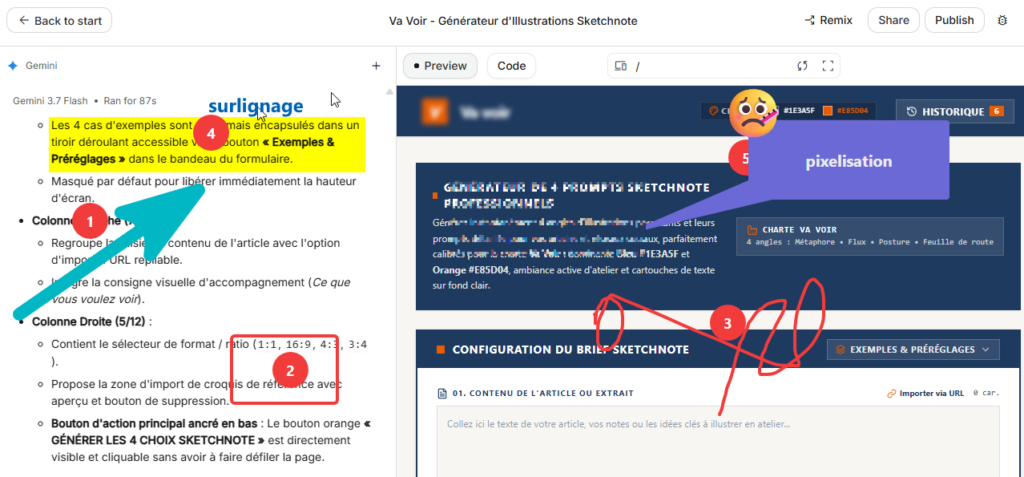
L’éditeur intégré propose de nombreux outils de dessin. Sur l’exemple ci-dessous, on retrouve :
Flèche, pour pointer un élément précis
Forme, ici un rectangle, pour encadrer une zone
Trait libre, pour dessiner à main levée
Surligner, pour mettre en évidence du texte ou une zone
Pixeliser une zone, combiné ici avec une boîte de texte et un émoticône, pour flouter une information tout en la commentant
En résumé
ShareX est un outil complet, gratuit, qui va bien au-delà de la simple capture d’écran. L’ajout du menu de tâches rapides après la capture m’a fait gagner du confort : je peux annoter à chaud, sans étape supplémentaire.
Tu synchronises déjà tes fichiers en temps réel entre plusieurs appareils, mais une synchronisation n’est pas une sauvegarde : une erreur ou une suppression accidentelle se propage aussi vite que le reste. Voici comment mettre en place une sauvegarde périodique automatisée d’un service cloud vers un autre, avec un script simple et fiable.
y, puis saisis le mot de passe Nextcloud (il sera masqué et stocké de façon obscurcie dans rclone.conf, pas en clair)
bearer_token>
Laisse vide, valide
Edit advanced config?
n
Keep this remote?
y
q) Quit config
q
Pour vérifier que c’est ok :
rclone lsd nextcloud:OBSIDIAN-sync
Tu dois voir le contenu de ton dossier OBSIDIAN-sync dans Nextcloud.
Étape 2 : configurer un remote vers la destination, limité à un dossier particulier
Par prudence, plutôt que de donner à rclone un accès à l’intégralité de ton espace de stockage de destination, il est possible de limiter un remote à un seul dossier, appelons le « folder », grâce à son identifiant unique.
Récupérer l’identifiant du dossier
Ouvre le dossier cible dans Google Drive, depuis un navigateur
Copie la chaîne de caractères qui suit folders/ dans l’URL, par exemple :
Choisis de créer un nouveau remote « gdrive-scope », sélectionne drive comme type de stockage, laisse les champs client_id et client_secret vides (valeurs par défaut), puis, à l’étape des réglages avancés (réponds y à la question Edit advanced config?), renseigne le champ root_folder_id avec l’identifiant récupéré à l’étape précédente.
Autoriser l’accès sans navigateur local (connexion SSH)
Si tu configures ce remote depuis une session SSH sans interface graphique, l’assistant propose une autorisation manuelle : il faut alors lancer rclone authorize "drive" sur une machine disposant d’un navigateur, se connecter avec le compte Google concerné, puis copier le jeton généré dans le terminal SSH en attente.
Vérifier l’accès
bash
rclone lsd gdrive-scope:
Cette commande devrait lister directement le contenu du dossier ciblé, sans que tu aies besoin de préciser de chemin.
Étape 3 : le script de sauvegarde
Le script copie le contenu source dans un dossier temporaire, le compresse en une seule archive, puis envoie cette archive vers la destination. Il prend en paramètre le nom du sous-dossier à sauvegarder, ce qui permet de le réutiliser pour plusieurs contenus différents avec une seule et même logique. En cas de besoin, l’archive se décompresse normalement pour retrouver les fichiers d’origine.
Attention, il faudra que tu modifies SOURCE_REMOTE (nextcloud:chemin-source/) et DEST_REMOTE (gdrive-scope:destination/) et tu remplaces USER par ton nom d’utilisateur dans le mini PC
#!/bin/bash
# Sauvegarde d'un dossier source (cloud A) vers un dossier destination (cloud B)
# Usage : backup-cloud-to-cloud.sh <nom-du-dossier>
# Exemple : backup-cloud-to-cloud.sh mon-dossier

set -e

FOLDER_NAME="$1"

if [ -z "$FOLDER_NAME" ]; then
  echo "Erreur : nom du dossier manquant. Usage : backup-cloud-to-cloud.sh <nom-du-dossier>"
  exit 1
fi

TIMESTAMP=$(date +%Y%m%d_%H%M%S)
TMP_BASE="/home/USER/tmp/cloud-backup"
TMP_DIR="${TMP_BASE}/${FOLDER_NAME}"
ARCHIVE_NAME="${FOLDER_NAME}_${TIMESTAMP}.tar.gz"
ARCHIVE_PATH="${TMP_BASE}/${ARCHIVE_NAME}"
SOURCE_REMOTE="nextcloud:chemin-source/${FOLDER_NAME}"
DEST_REMOTE="gdrive-scope:destination/${FOLDER_NAME}/"

echo "=== Sauvegarde ${FOLDER_NAME} - $(date) ==="

# Nettoyage préalable au cas où une exécution précédente aurait échoué
rm -rf "$TMP_DIR"
mkdir -p "$TMP_DIR"

# Copie depuis le cloud source vers un dossier temporaire local
echo "Copie depuis la source..."
rclone copy "$SOURCE_REMOTE" "$TMP_DIR" --transfers 4 --checkers 8 --fast-list

# Compression en une seule archive
echo "Compression..."
tar -czf "$ARCHIVE_PATH" -C "$TMP_BASE" "$FOLDER_NAME"

# Upload de l'archive unique vers la destination
echo "Upload vers la destination..."
rclone copy "$ARCHIVE_PATH" "$DEST_REMOTE" --transfers 1

# Nettoyage
rm -rf "$TMP_DIR"
rm -f "$ARCHIVE_PATH"

echo "=== Terminé - $(date) ==="
Si ce script tourne sur une machine où tu utilises sudo pour d’autres tâches, ne l’utilise jamais avec rclone. La commande sudo rclone réécrit le fichier de configuration rclone.conf avec les droits root lors du renouvellement d’un jeton d’accès, ce qui casse ensuite l’utilisation normale de rclone en tant qu’utilisateur courant. Seule une éventuelle commande tar nécessitant des droits élevés (rare dans ce cas précis, puisque le script travaille dans le dossier personnel de l’utilisateur) justifierait sudo, jamais rclone lui-même.
Étape 4 : planifier avec cron
Pour une sauvegarde hebdomadaire, chaque dimanche à 4h du matin :
La fréquence gagne à être adaptée à la criticité du contenu : un document en cours d’écriture active justifie un rythme hebdomadaire, un dossier de veille alimenté plus occasionnellement peut se contenter d’un rythme mensuel.
Assure-toi que le dossier de logs existe avant la première exécution planifiée :
bash
mkdir -p /home/USER/scripts/logs
Étape 5 : tester avant de laisser cron s’en charger
Un test manuel permet de vérifier le bon fonctionnement avant de dépendre entièrement de la planification automatique :
Vérifie ensuite, dans l’interface web du service de destination, que l’archive est bien apparue au bon endroit, avec un nom cohérent incluant l’horodatage.
Ce que ce schéma permet au-delà de ce cas précis
Ce principe (remote limité à un dossier, compression en une seule archive, upload unique, planification cron) se réutilise pour n’importe quelle paire de services cloud supportés par rclone, pas seulement Nextcloud vers Google Drive. C’est un schéma générique de sauvegarde périodique, applicable à d’autres contenus que des notes ou des documents.
Pour aller plus loin
Si ce projet t’intéresse, deux articles complémentaires détaillent la suite :

Commentaires récents