Tu as rédigé ton livre par chapitres dans Obsidian avec Longform (voir l’article précédent), et il faut maintenant en sortir un fichier Word exploitable, avec de vrais styles Titre 1, Titre 2, Titre 3. Voici la chaîne d’outils qui fonctionne, sans installer d’extension système lourde.
Pourquoi une exportation directe ne suffit pas
On se heurte à deux difficultés si on cherche à lire directement le fichier compilé dans Microsoft Word :
Les images ne sont pas intégrées au document compilé. Elles sont simplement reliées. Et ne s’affichent dans le document que si on le lit dans un lecteur de type VScode et seulement si le fichier est dans le même répertoire que les images.
Word ne peut pas (cf explication ci-dessous) lire correctement les balises <h1>, <h2>, <h3> en styles natifs Word Titre 1, Titre 2, Titre 3 : il les affiche comme des paragraphes « Normal » avec une mise en forme visuelle appliquée directement (gras, taille, couleur). En enregistrant ensuite en .docx, cette erreur est figée : le fichier final n’a aucun style de titre exploitable.
On passe donc par un enregistrement en mode Page Web, complète (.htm;.html) via un navigateur web pour que les images soient correctement incorporées au document. Et ensuite on utilise LibreOffice car il a un moteur de conversion HTML qui associe strictement les balises <h1>, <h2>, <h3> aux vrais styles Titre 1, Titre 2, Titre 3 du format .docx.
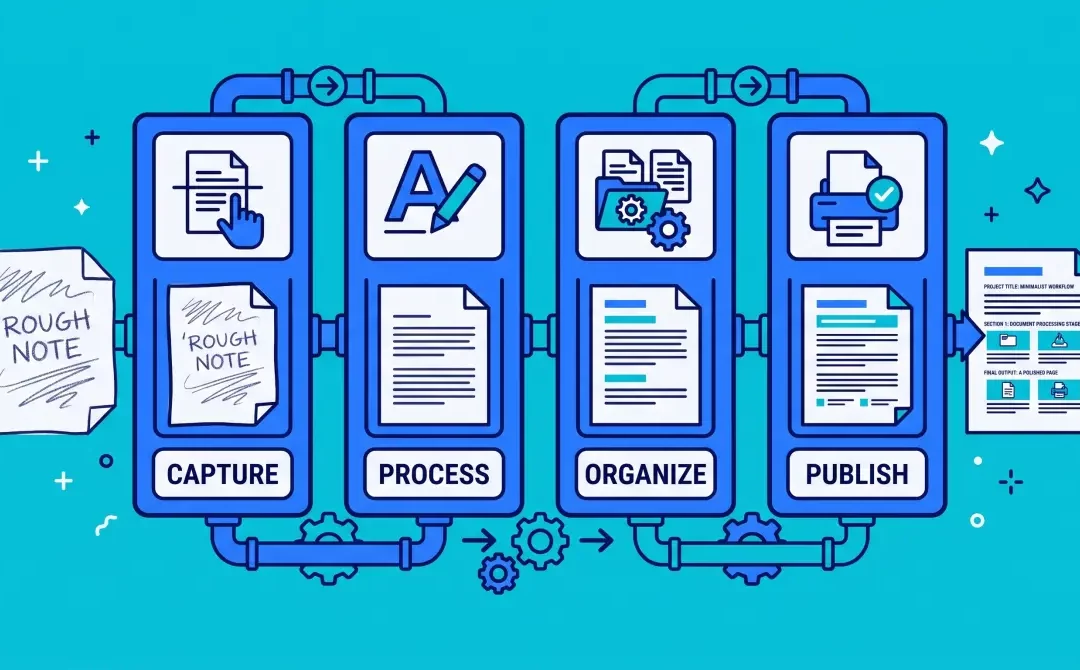
Vue d’ensemble de la chaîne d’outils
Obsidian (Longform)
      ↓ compilation (fichier manuscrit.md)
VSCodium (export HTML Offline)
      ↓ (fichier manuscrit.html)
Navigateur web (Enregistrer en "Page Web complète .htm")
      ↓ (fichier manuscrit.html qui contient ses propres images)
Gestionnaire de fichier windows (renommage en .doc)
      ↓ (fichier manuscrit.doc)
LibreOffice Writer (pivot de conversion vers .docx)
      ↓ (fichier manuscrit.docx avec titres en styles et pas en mode "normal")
Microsoft Word ou Google Docs (fichier final avec styles modifiables)
Étape 1 : compiler le manuscrit avec Longform
Toutes tes images doivent être regroupées dans un seul dossier du vault (_Illustrations dans l’article précédent), sans quoi elles ne suivront pas lors de l’export.
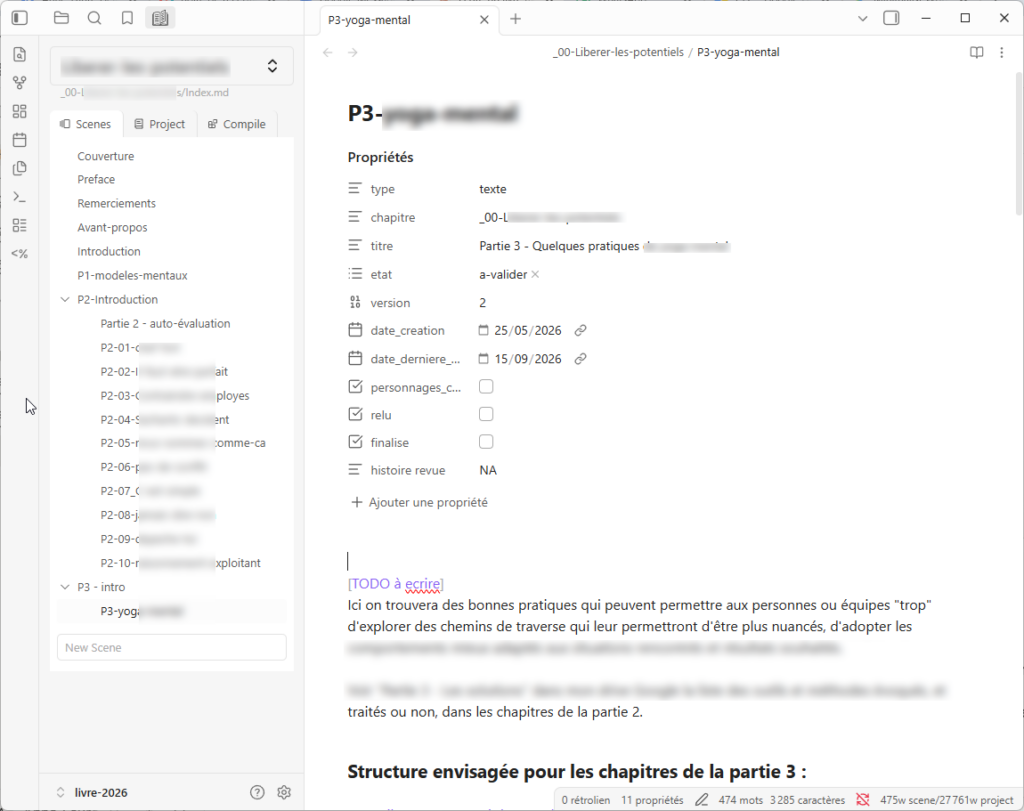
Dans le panneau Longform, onglet Compile :
Vérifie l’ordre des scènes/chapitres (glisser-déposer si besoin)
Coche Strip Frontmatter, pour supprimer les métadonnées YAML du haut de chaque fichier
Coche ou décoche Insert Chapter Titles selon que tes titres de chapitre sont déjà écrits dans le texte de chaque scène, ou seulement définis dans les propriétés
Lance la compilation
Longform génère un fichier unique, par exemple manuscrit.md, dans le dossier de tes scènes.
Étape 2 : exporter en HTML avec VSCodium
Le fichier à exporter doit être placé dans le dossier _Illustrations, sans quoi les images ne suivront pas. Le fichier HTML se crée aussi dans ce dossier.
Ouvre le fichier compilé (manuscrit.md) avec VSCodium
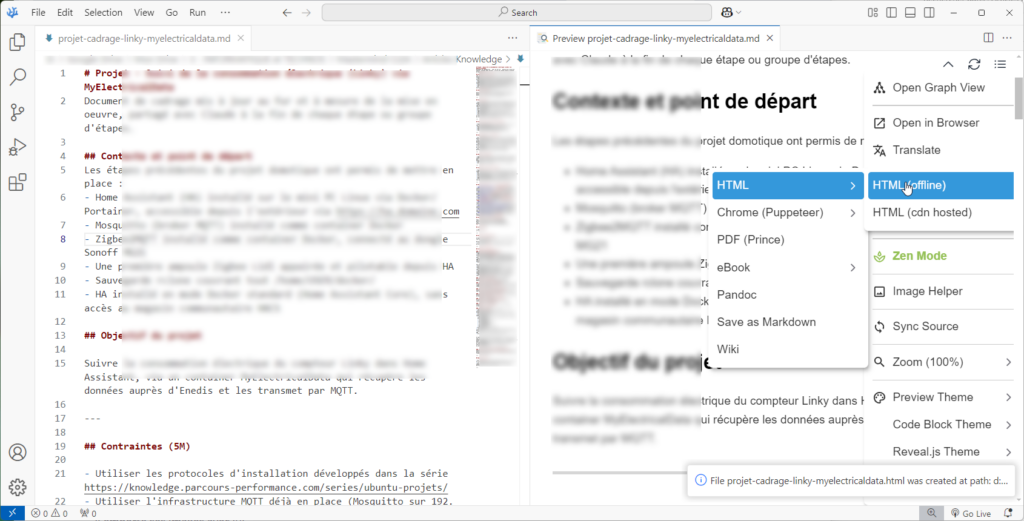
Ouvre l’aperçu Markdown Preview Enhanced (Ctrl+K puis V). Si nécessaire installe l’extension Markdown Preview Enhanced dans VSCodium.
Dans le panneau d’aperçu, clic droit n’importe où sur la page
Choisis HTML puis HTML (Offline)
Résultat : un fichier manuscrit.html est créé à côté de tes fichiers Markdown.
Étape 3 : « Page Web complète » depuis le navigateur
Le fichier HTML doit lui aussi être dans _Illustrations pour cette étape. Le fichier .htm obtenu, lui, pourra être déplacé ailleurs ensuite, car il emporte ses images avec lui.
Ouvre manuscrit.html dans un navigateur (Chrome, Edge, Firefox)
Clic droit sur la page, Enregistrer sous… (ou Ctrl+S)
Dans le champ Type, sélectionne impérativement Page Web, complète (.htm;.html)
Choisis le dossier de destination et valide
Résultat : un fichier .html (par exemple manuscritComplet.html) qui intègre les images.
Étape 4 : pivot par LibreOffice Writer
C’est le point le plus sensible de la chaîne. Ouvrir directement le fichier .htm dans LibreOffice Writer ne fonctionne pas de façon fiable, le résultat dépend de la méthode d’ouverture utilisée. La seule méthode qui fonctionne à coup sûr :
Fais une copie du fichier .htm
Renomme cette copie avec l’extension .doc (par exemple manuscritComplet.doc)
Ouvre ce fichier .doc avec LibreOffice Writer
Vérifie que les niveaux de titre sont bien reconnus (Titre 1, Titre 2, Titre 3 dans le volet des styles)
Enregistre sous format .docx
Étape 5 : finaliser dans Word ou Google Docs
Ouvre le fichier .docx obtenu avec Microsoft Word, ou dépose-le dans Google Drive pour l’ouvrir avec Google Docs.
Les titres sont reconnus avec les vrais styles Word (Titre 1, Titre 2, Titre 3), modifiables en un clic depuis le volet des styles
Les images apparaissent à leur emplacement, mais pas à la largeur définie dans Obsidian, il faut les redimensionner manuellement (voir la macro ci-dessous)
Le fichier .docx est autonome, il n’a plus besoin des fichiers sources
Redimensionner et centrer les images automatiquement
Écrire ![[image.png|550]] dans Obsidian ne suffit pas à contrôler la taille finale dans Word : les images arrivent à leur taille d’origine après le passage par la chaîne d’export. Cette macro Word parcourt le document et réduit à 15 cm toutes les images qui dépassent cette largeur, proportions conservées, puis les centre.
Dans Word, Alt + F11 pour ouvrir l’éditeur de macro (ou onglet Développeur > Visual Basic)
Menu Insert > Module
Colle le code suivant :
vba
Sub RedimensionnerEtCentrerImages()
    Dim img As InlineShape
    Dim maxLargeurCm As Single
    Dim maxLargeurPoints As Single

    ' Définition de la largeur max à 15 cm
    maxLargeurCm = 15
    maxLargeurPoints = CentimetersToPoints(maxLargeurCm)

    ' Parcours de toutes les images du document
    For Each img In ActiveDocument.InlineShapes
        If img.Type = wdInlineShapePicture Or img.Type = wdInlineShapeLinkedPicture Then
            ' Redimensionnement si nécessaire
            If img.Width > maxLargeurPoints Then
                img.LockAspectRatio = msoTrue
                img.Width = maxLargeurPoints
            End If

            ' Alignement centré du paragraphe contenant l'image
            img.Range.ParagraphFormat.Alignment = wdAlignParagraphCenter
        End If
    Next img

    MsgBox "Toutes les images ont été ajustées (15 cm max) et centrées !", vbInformation, "Terminé"
End Sub
Enregistre : Word te proposera de conserver le format .docx sans macro, refuse et enregistre le document au format acceptant les macros
F5 (ou le bouton Lecture) pour exécuter la macro
Une autre piste, non testée dans vscodium : Pandoc
Pandoc, avec l’extension « Obsidian Pandoc » ou en ligne de commande, permettrait probablement d’exporter directement vers un .docx exploitable, sans passer par tout ce détour. Je ne l’ai pas testé : ça suppose d’installer un outil externe dont je ne connaissais pas la fiabilité, pour un besoin ponctuel. Si tu es plus à l’aise avec l’installation d’outils en ligne de commande, ça vaut sans doute le coup d’essayer avant de te lancer dans la chaîne décrite ici.
Limites connues, pour une prochaine fois
Les propriétés de titre ne sont pas correctement reprises à la compilation : c’est le nom du fichier qui est utilisé comme titre, pas la propriété titre définie dans le modèle
La macro de redimensionnement s’applique à toutes les images sans distinction : des petites images déjà à la bonne taille (par exemple des schémas illustratifs) se retrouvent elles aussi recentrées, alors qu’elles devraient rester alignées avec le texte
Les tableaux ne sont pas redimensionnés à la largeur du texte, ni alignés verticalement au centre, un ajustement manuel reste nécessaire
Écrire un livre (un essai dans mon cas, pas un roman), ce n’est pas seulement rédiger : c’est aussi retrouver un personnage cité au chapitre 3 quand on l’évoque au chapitre 9, savoir quel chapitre est prêt et lequel ne l’est pas, et un jour assembler tout ça en un seul document. Voici comment répondre à ces besoins dans Obsidian.
Ce dont tu as besoin pour écrire un livre sans t’y perdre
Au fil de la rédaction, plusieurs besoins reviennent, quel que soit le sujet du livre :
Une structure globale : voir l’ensemble des chapitres, les réorganiser facilement, sans dépendre de l’ordre dans lequel les fichiers ont été créés
Un espace de travail par chapitre : rédiger un chapitre sans que les notes de travail (idées, sources, remarques à soi-même) se mélangent au texte final
Un endroit où vont se ranger les images et autres éléments que je colle dans les chapitres ou notes.
Une mémoire des personnages et des notions récurrentes : éviter d’oublier qu’un personnage a déjà été présenté ailleurs, ou de redéfinir deux fois la même notion. Si tu ancres tes idées dans des cas concrets comme moi, tu auras vite affaire à de nombreux personnages, dont la vie professionnelle inspirera tes lecteurs.
Une vue d’ensemble de l’avancement : savoir en un coup d’œil quels chapitres sont terminés, lesquels restent à relire, et quelles questions sont encore en suspens
Un moyen de générer le manuscrit complet : assembler tous les chapitres, dans l’ordre, en un seul fichier propre
Des sauvegardes régulières : un projet de plusieurs mois de travail ne peut pas reposer uniquement sur la synchronisation entre appareils
Comment y répondre : la solution retenue
Trois extensions Obsidian couvrent ces besoins, chacune sur un point précis.
Besoin
Réponse
Extension
Structure globale, réorganisation des chapitres
Panneau dédié avec glisser-déposer, compilation en un clic
Longform
Isoler le texte final des notes de travail, chapitre par chapitre
Un fichier texte et un fichier notes par chapitre
Organisation du vault (pas d’extension)
Stocker les images et pièces jointes sans les disperser dans le vault
Dossier dédié aux pièces jointes, configuré une fois pour toutes
Réglage natif d’Obsidian (pas d’extension)
Fiches de personnages et de notions sans repartir de zéro
Modèles de fichiers pré-remplis
Templater
Vue d’ensemble de l’avancement
Tableau de bord qui se met à jour automatiquement
Dataview
Protection contre les fausses manipulations
Historique automatique des fichiers
File Recovery (natif)
Sécurité du projet dans son ensemble
Sauvegarde périodique indépendante de la synchronisation
Voir l’article dédié, mentionné plus bas
Concrètement : chaque chapitre vit dans son propre dossier, avec un fichier texte.md (ce que lira le lecteur) et des fichiers notes.md (tout le reste). Longform assemble tous les texte.md, dans l’ordre que tu définis, pour produire le manuscrit final. Templater crée automatiquement des fiches à structure identique pour chaque personnage ou notion récurrente, à partir de modèles que tu ne rédiges qu’une seule fois. Dataview scanne l’ensemble du vault pour construire un tableau de bord : état de chaque chapitre, tâches en attente, questions non résolues.
La suite de l’article détaille la mise en œuvre technique de chaque brique. Si la vision d’ensemble te suffit pour l’instant, tu peux t’arrêter ici et y revenir plus tard.
Mise en œuvre technique
On considère que tu as installé les extensions dans ton vault.
Organiser le vault
Chaque chapitre repose sur un fichier texte, et un ou plusieurs fichiers de notes :
texte.md : le texte destiné au lecteur, le seul compilé par Longform
notes.md et d’autres fichiers de notes si besoin : tout le reste (notes de travail, sources, instructions à soi-même)
mon-livre/
│
├── 00-Avant-propos/
│   ├── texte.md
│   └── notes.md
├── 01-Introduction/
├── Partie-1/
│   ├── Chapitre-01/
│   ├── Chapitre-02/
├── Partie-2/
│   ├── Chapitre-03/
├── _Personnages/          ← fiches des personnages ou cas cités
├── _Concepts/              ← fiches de notions transversales
├── _Illustrations/          ← toutes les pièces jointes
├── _Templates/             ← modèles de fichiers
├── _Versions/               ← archives manuelles
└── _Tableau-de-bord.md    ← vue d'ensemble du projet
Le préfixe _ fait remonter ces dossiers en haut de l’explorateur de fichiers.
Ranger les images automatiquement
Pour éviter de disperser les illustrations dans les dossiers de chapitres, configure un dossier unique pour toutes les pièces jointes :
Ouvre Paramètres > Fichiers et liens
Dans « Emplacement par défaut des nouvelles pièces jointes », choisis « Dans le dossier indiqué ci-dessous »
Indique _Illustrations
Toute image collée ou glissée dans un chapitre atterrit désormais automatiquement dans ce dossier, quel que soit l’endroit où tu la colles.
Convention de nommage
Pour retrouver facilement une image et savoir d’où elle vient, nomme-la selon le schéma partie-chapitre-description, par exemple :
P2-02-secret.png
P2 pour la partie 2, 02 pour le chapitre 2, secret pour une description courte du contenu.
Insérer une image dans un chapitre
Utilise la syntaxe Wikilink standard, avec le nom du fichier tel qu’il apparaît dans _Illustrations :
![[P2-02-secret.png]]
Pour limiter sa largeur d’affichage, ajoute la largeur en pixels après un | :
![[P2-02-secret.png|500]]
Cette image s’intègre automatiquement dans le manuscrit compilé par Longform, sujet détaillé dans l’article suivant.
Configurer Longform
Créer le projet
Clic droit sur le dossier racine du vault
Sélectionner « Créer un projet Longform »
Nommer le projet
Choisir le format multi-scènes
Longform crée un fichier pivot qui sert de colonne vertébrale au manuscrit.
Gérer l’ordre des chapitres
L’ordre des scènes se gère dans le panneau Longform (icône dans la barre latérale gauche), onglet « Scenes ». Les chapitres se réorganisent par glisser-déposer, sans éditer de fichier YAML à la main. L’indentation dans ce panneau permet de créer des hiérarchies (parties > chapitres) sans toucher aux dossiers physiques.
Gérer les versions de rédaction (Drafts)
Longform permet de créer plusieurs brouillons d’un même projet (V1, V2…) via l’onglet « Project ». Chaque brouillon conserve sa propre structure de scènes, ce qui permet de restructurer une V2 tout en gardant la V1 intacte.
Configurer Templater
Configuration initiale
Dans Paramètres > Templater :
Template folder location : _Templates
Trigger Templater on new file creation : activer
Folder Templates : associer chaque dossier à son modèle
Dossier
Modèle
_Personnages
modele-fiche-personnage
_Concepts
modele-fiche-concept
Pour les dossiers de chapitres (modele-texte-chapitre.md et modele-notes-chapitre.md), mieux vaut passer par la palette de commandes au moment de créer le fichier (voir ci-dessous), plutôt que par une association automatique.
Utilisation au quotidien
Deux façons d’appliquer un modèle :
Créer un fichier dans un dossier associé : Templater l’applique automatiquement
Ou : Ctrl+P > « Templater : Insert template » > choisir le modèle manuellement
Les modèles de fichiers
J’ai créé 4 fichiers dans _Templates/ avant de commencer la rédaction. Je te montre le premier modèle. Les autres sont sur le même principe.
Les valeurs possibles pour le champ etat : a-nettoyer / en-cours-nettoyage / nettoye / a-relire / finalise.
La procédure de nettoyage d’un chapitre
Sept étapes, à répéter pour chaque chapitre.
1. Créer les fichiers du chapitre
Dans le dossier du chapitre, crée texte.md et des fichiers notes.md à partir des modèles Templater.
2. Coller le contenu brut
Copie le contenu du chapitre depuis ton brouillon global. Colle-le dans texte.md.
3. Trier
A déplacer dans notes.md
A garder dans texte.md
« Illustration possible : … »
Tout le texte rédigé
« Voir aussi [lien web] »
Les citations
« A exploiter / à creuser »
Les exemples et cas concrets
Sorties ChatGPT/Gemini brutes
Les tableaux
Questions à soi-même
Le récapitulatif
4. Baliser les tâches restantes
Dans texte.md, signale les passages à retravailler avec la syntaxe de tâche Markdown :
- [ ] Revoir ce passage - manque d'exemple #todo
- [ ] Vérifier la cohérence avec le chapitre 3 #coherence
Dataview les centralisera automatiquement dans le tableau de bord.
5. Mettre à jour l’en-tête
Change etat et date_derniere_modif dans le bloc YAML.
6. Créer ou compléter les fiches
Pour chaque personnage ou concept mentionné dans le chapitre, vérifie s’il a une fiche dans _Personnages/ ou _Concepts/, crée-la si besoin.
7. Lier les chapitres entre eux
Dans certains fichiers de notes, section « Liens vers autres chapitres » :
- Renforce [[Chapitre-04/texte]]
- Contraste avec [[Chapitre-06/texte]]
- Lien avec concept [[_Concepts/Concept-A]]
Le tableau de bord avec Dataview
Contenu de _Tableau-de-bord.md. Les requêtes se mettent à jour automatiquement à chaque modification du vault.
Etat des chapitres
TABLE titre, etat, relu, finalise
FROM "/"
WHERE type = "texte"
SORT chapitre ASC
Tâches en suspens dans le manuscrit
TASK
FROM "/"
WHERE !completed
SORT file.name ASC
Questions en suspens
TABLE question AS "Question", file.name AS "Chapitre"
FROM "/"
WHERE question != null
Concepts par famille
TABLE famille
FROM "_Concepts"
WHERE type = "concept"
SORT famille ASC
Gérer les versions
Protection automatique : File Recovery
Obsidian sauvegarde automatiquement des instantanés de chaque fichier toutes les 5 minutes. Pour restaurer : Paramètres > Plugins principaux > File Recovery > View. Tu cherches le fichier, tu vois l’historique, tu restaures la version choisie.
Protection manuelle avant révision importante
Avant toute révision importante, notamment avant de travailler avec une IA :
Copie le fichier texte.md dans _Versions/
Renomme-le avec la date, par exemple Chapitre-03-2026-05-20.md
Travaille sur le fichier original
Brouillons Longform pour les restructurations majeures
Si tu envisages de modifier l’ordre des chapitres ou de fusionner des parties, crée un nouveau Draft dans Longform plutôt que de modifier directement. La version précédente reste intacte pour comparaison ou restauration.
Sauvegardes : ne pas s’arrêter à la synchronisation
File Recovery protège contre une fausse manipulation locale, mais ni File Recovery ni la synchronisation ne protègent contre une suppression propagée sur tous les appareils, ou une corruption de fichier répliquée avant que tu t’en rendes compte. Une sauvegarde périodique, indépendante du mécanisme de synchronisation, reste indispensable pour un projet de cette ampleur.
Dans l’article précédent, j’ai comparé 5 modèles de langage installés sur un mini PC. Et j’ai réglé la « température » (quel drôle de mot) sur 0.2. Ca m’a fait me demander quelle était l’importance de la température d’un modèle de langage sur la qualité de ses résultats. Et je me suis rendue compte qu’il y a aussi une notion de « system prompt » qui peut avoir une incidence sur la qualité des résultats. Alors j’ai décidé de lancer un test, avec un seul modèle, qui fait varier les températures et le system prompt. Le résultat m’a beaucoup appris sur les modèles de langage.
La température contrôle le degré d’imprévisibilité du texte généré. À chaque mot, le modèle calcule une probabilité pour plusieurs mots suivants possibles. Une température basse (proche de 0) pousse le modèle à toujours choisir le mot le plus probable, ce qui donne des réponses stables et répétitives. Une température plus haute laisse le modèle piocher parmi des mots moins probables, ce qui donne des réponses plus variées et plus créatives, mais aussi plus de risque de dérive ou d’invention.
Le system prompt est une instruction envoyée au modèle avant la conversation elle-même, invisible pour l’utilisateur final. Elle sert à cadrer le comportement du modèle, par exemple « réponds de façon concise » ou « tu es un assistant technique rigoureux ».
Un point important à connaître si tu passes d’une interface comme Open WebUI à un appel direct via l’API d’Ollama : Open WebUI injecte souvent un system prompt par défaut, invisible dans l’interface. Un appel direct à l’API d’Ollama, comme dans le script ci-dessous, n’en contient aucun sauf si tu le précises explicitement dans la requête. C’est une des raisons pour lesquelles un même modèle peut sembler se comporter différemment selon l’interface utilisée.
Le protocole
L’idée : tester Gemma 4 E2B sur le même prompt (logique, traduction, poésie) que dans le comparatif précédent, avec 5 répétitions par configuration, pour distinguer une tendance réelle du simple hasard.
Deux variables testées :
la température : 0,2, 0,5 et 0,8
la présence ou non d’un system prompt de concision
Soit 2 configurations de system prompt x 3 températures x 5 runs, un total de 30 exécutions.
À chaque run, le script exécute docker exec ollama ollama stop gemma4:e2b et attend 2 secondes pour garantir que le modèle est bien déchargé de la mémoire avant de relancer la génération suivante.
#!/bin/bash

MODEL="gemma4:e2b"

PROMPT="Résous ce problème de logique étape par étape : Trois personnes (Alice, Bob et Charlie) ont chacune une couleur de pull différente (Bleu, Rouge, Vert). Alice dit qu'elle ne porte pas de bleu. Charlie porte un pull vert. Quelle est la couleur du pull de Bob ? Ensuite, traduis cette expression anglaise de manière naturelle en français : 'It is raining cats and dogs'. Enfin, écris une seule phrase poétique sur la pluie."

SYSTEM_PROMPT="Tu es un assistant virtuel logique, précis et concis. Analyse les contraintes fournies sans inventer d'éléments extérieurs."

TEMPS=(0.2 0.5 0.8)
RUNS=5
OUTPUT_FILE="resultats_gemma.txt"

echo "=== BENCHMARK GEMMA 4 E2B : STABILITÉ & SYSTEM PROMPT ===" > "$OUTPUT_FILE"
echo "Date : $(date)" >> "$OUTPUT_FILE"
echo "--------------------------------------------------" >> "$OUTPUT_FILE"

# Boucle avec et sans System Prompt
for USE_SYS in "SANS" "AVEC"; do
  for TEMP in "${TEMPS[@]}"; do
    echo "=================================================="
    echo "Configuration : System Prompt [$USE_SYS] | Température [$TEMP]"
    echo "=================================================="
    echo "==================================================" >> "$OUTPUT_FILE"
    echo "CONFIG : System Prompt [$USE_SYS] | Température [$TEMP]" >> "$OUTPUT_FILE"
    echo "==================================================" >> "$OUTPUT_FILE"

    for ((i=1; i<=RUNS; i++)); do
      echo -ne "Exécution $i/$RUNS...\r"

      # Vider la mémoire RAM/VRAM avant chaque run
      docker exec ollama ollama stop "$MODEL" > /dev/null 2>&1
      sleep 2

      # Construction du payload selon la présence du system prompt
      if [ "$USE_SYS" == "AVEC" ]; then
        PAYLOAD=$(jq -n \
          --arg model "$MODEL" \
          --arg prompt "$PROMPT" \
          --arg system "$SYSTEM_PROMPT" \
          --argjson temp "$TEMP" \
          '{model: $model, prompt: $prompt, system: $system, stream: false, options: {temperature: $temp}}')
      else
        PAYLOAD=$(jq -n \
          --arg model "$MODEL" \
          --arg prompt "$PROMPT" \
          --argjson temp "$TEMP" \
          '{model: $model, prompt: $prompt, stream: false, options: {temperature: $temp}}')
      fi

      START_TIME=$(date +%s.%N)
      RESPONSE=$(curl -s http://localhost:11434/api/generate \
        -H "Content-Type: application/json" \
        -d "$PAYLOAD")
      END_TIME=$(date +%s.%N)
      ELAPSED=$(echo "$END_TIME - $START_TIME" | bc)

      TEXT=$(echo "$RESPONSE" | jq -r '.response // "Erreur"')
      EVAL_COUNT=$(echo "$RESPONSE" | jq -r '.eval_count // 0')
      EVAL_DURATION=$(echo "$RESPONSE" | jq -r '.eval_duration // 0')

      if [ "$EVAL_DURATION" -gt 0 ] 2>/dev/null; then
        TPS=$(echo "scale=2; $EVAL_COUNT / ($EVAL_DURATION / 1000000000)" | bc -l)
      else
        TPS="N/A"
      fi

      # Écriture des résultats dans le fichier log
      echo "--- Run $i/$RUNS (${ELAPSED}s | ${TPS} tok/s | ${EVAL_COUNT} tokens) ---" >> "$OUTPUT_FILE"
      echo "$TEXT" >> "$OUTPUT_FILE"
      echo "" >> "$OUTPUT_FILE"
    done

    echo -e "Configuration terminée !          "
  done
done

# Nettoyage final
docker exec ollama ollama stop "$MODEL" > /dev/null 2>&1
echo "=== FIN DU BENCHMARK ==="
echo "Tous les résultats ont été enregistrés dans : $OUTPUT_FILE"
Copie ce script dans un fichier test_gemma.sh, rends-le exécutable (chmod +x test_gemma.sh) et lance-le. Les résultats s’écrivent automatiquement dans resultats_gemma.txt. Compte-toi plusieurs heures d’exécution, 30 runs sur un modèle qui répond en 90 à 110 secondes en moyenne, ça prend du temps.
Une stabilité remarquable sur la logique et la traduction
Sur les 30 exécutions, Gemma 4 E2B obtient un score parfait : 30 sur 30 sur la déduction logique et sur la traduction idiomatique. Même à une température de 0,8, le modèle ne dérive pas et ne se met pas à inventer une couleur ou une traduction fantaisiste.
L’effet du system prompt sur la concision
L’ajout du system prompt de concision change nettement le comportement du modèle :
le nombre moyen de tokens générés passe d’environ 966 (sans) à environ 802 (avec), soit une baisse d’environ 17%
le temps moyen d’exécution passe d’environ 108 secondes à environ 92 secondes par run
sans system prompt, le modèle a tendance à répéter l’énoncé et à ajouter des phrases d’introduction (« Voici la résolution… »), ce que le system prompt supprime
Une vitesse d’inférence constante
Sur l’ensemble des 30 runs, la vitesse brute reste comprise entre 9,80 et 9,87 tokens par seconde, quelle que soit la configuration. Ça confirme que ni la température ni le system prompt ne changent l’effort de calcul par token : ils jouent uniquement sur la longueur et la structure du texte généré.
Et la créativité poétique ?
À température 0,2, les métaphores se répètent beaucoup d’un run à l’autre, la même formulation revient plusieurs fois sur les 5 runs d’une même configuration. À température 0,8, le vocabulaire se diversifie nettement, tout en restant grammaticalement correct.
Ce que je retiens
Gemma 4 E2B se montre robuste sur les tâches factuelles, peu importe la température testée ici. Le vrai levier d’optimisation n’est pas la précision, elle est déjà excellente, mais la vitesse de traitement : ajouter un system prompt de concision réduit le temps de traitement d’environ 17% sans perdre en fiabilité.
Une limite à garder en tête
Ce test ne porte que sur Gemma 4 E2B. Il est possible que d’autres modèles réagissent différemment à un system prompt de concision, ça reste à vérifier avec le même protocole.
J’ai comparé quatre modèles LLM en local dans un premier article, en juin. J’avais réalisé les essais à la main, en ligne de commande. Ici j’ai voulu comparer ces modèles à Gemma 4 E2B, un modèle récent. et j’ai choisi de le faire en automatique, via un script bash. Ma seule contribution pendant le comparatif, c’était de regarder la charge du système avec chaque modèle. J’étais chargée de faire des captures d’écran, le script faisait tout le reste !
La température est un réglage qui contrôle le degré d’imprévisibilité d’un modèle. Une température basse pousse le modèle vers la réponse la plus probable, donc plus stable et plus factuelle. Une température haute laisse plus de place à la variation, ce qui est utile pour la créativité mais augmente le risque d’inventer des éléments qui n’ont pas de sens.
Pour comparer des modèles sur leur capacité à raisonner et traduire correctement, j’ai réglé tous les modèles à une température de 0,2. Par défaut, Open WebUI utilise une température plus élevée (autour de 0,8), pensée pour des usages conversationnels plus créatifs. C’est un choix qui a un impact réel sur les résultats, je détaille cet aspect dans un article, ici, dédié à la température et au system prompt.
Avant de démarrer
Avant tout test, j’ai mis à jour tous mes containers Docker via Portainer (voir l’article dédié), pour être certaine que chaque modèle tourne sur la dernière version d’Ollama.
J’ai aussi arrêté temporairement les containers non essentiels pendant le test (Home Assistant, Tika, Stirling-PDF, Mosquitto, Zigbee2MQTT), pour éviter qu’ils ne consomment de la RAM ou du CPU en arrière-plan et faussent les mesures.
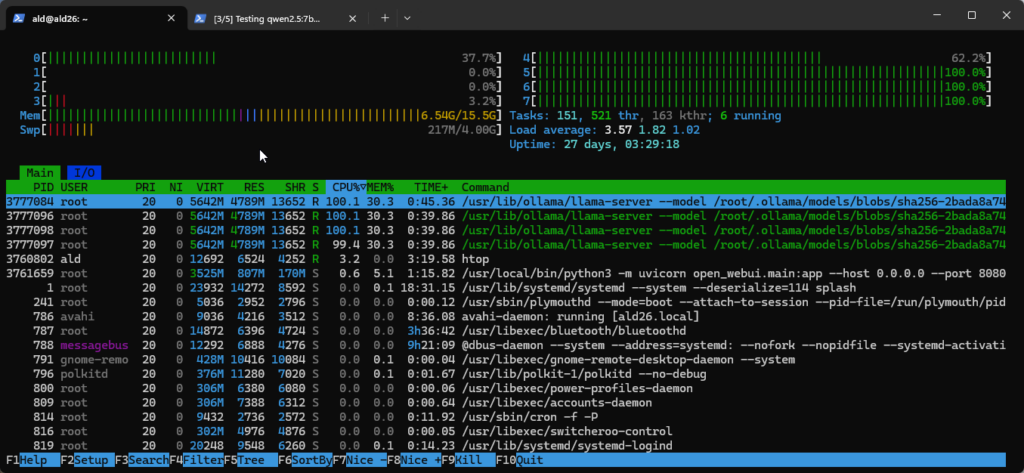
Un second terminal SSH avec htop ouvert en parallèle permet de suivre la consommation de RAM et de CPU pendant chaque test.
Le protocole
Les cinq modèles comparés, tous réglés à température 0,2 :
Gemma 4 E2B
Qwen 2.5 3B
Qwen 2.5 7B
Mistral 7B
Llama 3.1 8B
Chaque modèle reçoit le même prompt, qui combine trois tâches différentes : un problème de logique, une traduction d’expression idiomatique, et une phrase poétique. Ce format permet de juger plusieurs capacités en un seul appel, mais il faut garder en tête qu’un échec sur une tâche ne dit rien des deux autres.
Installe d’abord jq et bc, deux outils utilisés par le script :
bash
sudo apt install jq bc
jq est un processeur JSON en ligne de commande. Comme l’API d’Ollama renvoie ses réponses en JSON, jq sert à en extraire la réponse du modèle, le nombre de tokens générés ou le temps de calcul. bc est une calculatrice en ligne de commande qui gère les nombres à virgule, ce que Bash ne sait pas faire nativement, utile ici pour calculer la vitesse en tokens par seconde.
Crée ensuite le script :
sudo nano /home/USER/benchmark.sh
Colle-y ce contenu :
#!/bin/bash

MODELS=(
  "gemma4:e2b"
  "qwen2.5:3b"
  "qwen2.5:7b"
  "mistral:latest"
  "llama3.1:latest"
)

PROMPT="Résous ce problème de logique étape par étape : Trois personnes (Alice, Bob et Charlie) ont chacune une couleur de pull différente (Bleu, Rouge, Vert). Alice dit qu'elle ne porte pas de bleu. Charlie porte un pull vert. Quelle est la couleur du pull de Bob ? Ensuite, traduis cette expression anglaise de manière naturelle en français : 'It is raining cats and dogs'. Enfin, écris une seule phrase poétique sur la pluie."
JSON_PROMPT=$(jq -rn --arg x "$PROMPT" '$x')

TOTAL=${#MODELS[@]}
INDEX=1

echo "=== DÉBUT DU BENCHMARK ==="
echo "Température : 0.2"
echo "--------------------------------------------------"

for MODEL in "${MODELS[@]}"; do
  # Mise à jour du titre de l'onglet du terminal
  echo -ne "\033]0;[$INDEX/$TOTAL] Pulling $MODEL...\007"
  echo ""
  echo "[$INDEX/$TOTAL] >>> Mise à jour et récupération des infos de : $MODEL"

  # 1. Mise à jour du modèle
  docker exec ollama ollama pull "$MODEL" > /dev/null 2>&1

  # 2. Récupération des informations de version (Digest / Quantization)
  SHOW_INFO=$(curl -s http://localhost:11434/api/show -d "{\"model\": \"$MODEL\"}")
  FAMILY=$(echo "$SHOW_INFO" | jq -r '.details.family // "inconnu"')
  QUANT=$(echo "$SHOW_INFO" | jq -r '.details.quantization_level // "inconnu"')

  # Récupération de l'ID/Digest du modèle via Ollama CLI
  MODEL_ID=$(docker exec ollama ollama list | grep -E "^$(echo $MODEL | cut -d: -f1)" | awk '{print $2}' | head -n 1)

  # 3. Nettoyage VRAM/RAM
  docker exec ollama ollama stop "$MODEL" > /dev/null 2>&1
  sleep 3

  # Mise à jour du titre de l'onglet pendant le test
  echo -ne "\033]0;[$INDEX/$TOTAL] Testing $MODEL...\007"
  echo ">>> Exécution du test..."

  # 4. Envoi de la requête API et mesure
  START_TIME=$(date +%s.%N)

  RESPONSE=$(curl -s http://localhost:11434/api/generate -d "{
    \"model\": \"$MODEL\",
    \"prompt\": $JSON_PROMPT,
    \"options\": {
      \"temperature\": 0.2
    },
    \"stream\": false
  }")

  END_TIME=$(date +%s.%N)
  ELAPSED=$(echo "$END_TIME - $START_TIME" | bc)

  # Extraction des métriques
  TEXT=$(echo "$RESPONSE" | jq -r '.response')
  EVAL_COUNT=$(echo "$RESPONSE" | jq -r '.eval_count')
  EVAL_DURATION=$(echo "$RESPONSE" | jq -r '.eval_duration')

  TPS=$(echo "scale=2; $EVAL_COUNT / ($EVAL_DURATION / 1000000000)" | bc -l 2>/dev/null || echo "N/A")

  # 5. Affichage des résultats
  echo "--------------------------------------------------"
  echo "MODÈLE         : $MODEL"
  echo "ID (Digest)    : ${MODEL_ID:-N/A}"
  echo "Format / Quant : $FAMILY ($QUANT)"
  echo "Temps total    : ${ELAPSED}s"
  echo "Tokens générés : $EVAL_COUNT"
  echo "Vitesse        : ${TPS} tok/s"
  echo "--------------------------------------------------"
  echo "Réponse :"
  echo "$TEXT"
  echo "--------------------------------------------------"

  # Nettoyage
  docker exec ollama ollama stop "$MODEL" > /dev/null 2>&1
  ((INDEX++))
  sleep 2
done

# Remet le titre par défaut du terminal
echo -ne "\033]0;Terminal\007"
echo "=== BENCHMARK TERMINÉ ==="
Rends-le exécutable et lance-le :
sudo chmod +x benchmark.sh
./benchmark.sh
Le script se charge de :
mettre à jour chaque modèle avant de le tester
vider complètement la RAM entre deux modèles, pour ne pas fausser les mesures
envoyer le prompt via l’API d’Ollama avec la température fixée à 0,2
mesurer le temps de réponse total
calculer la vitesse de génération en tokens par seconde
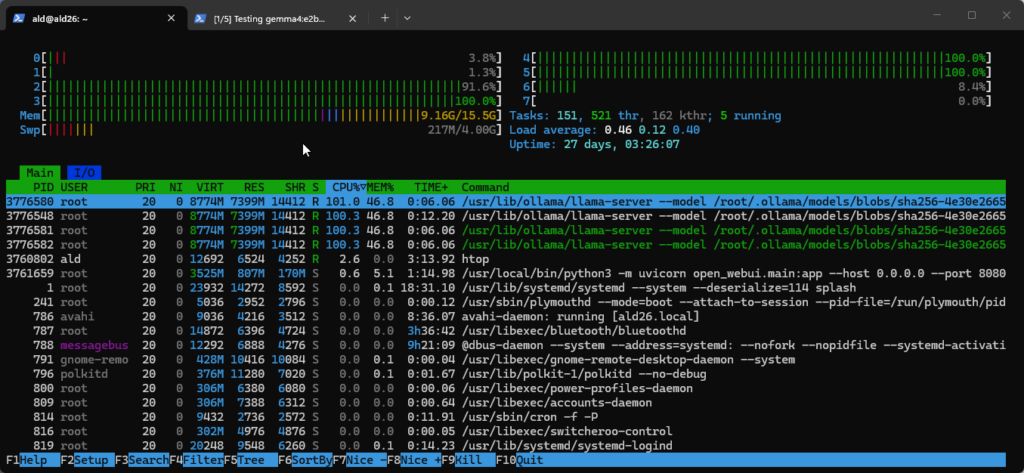
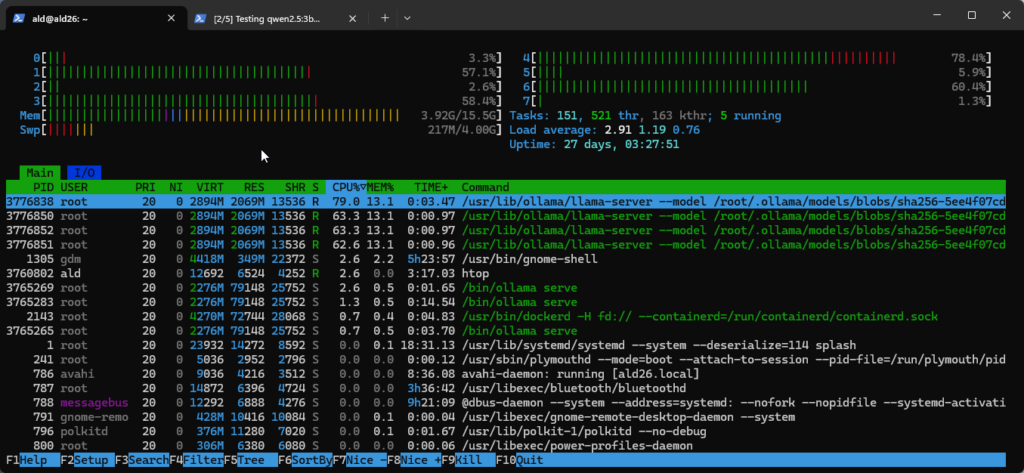
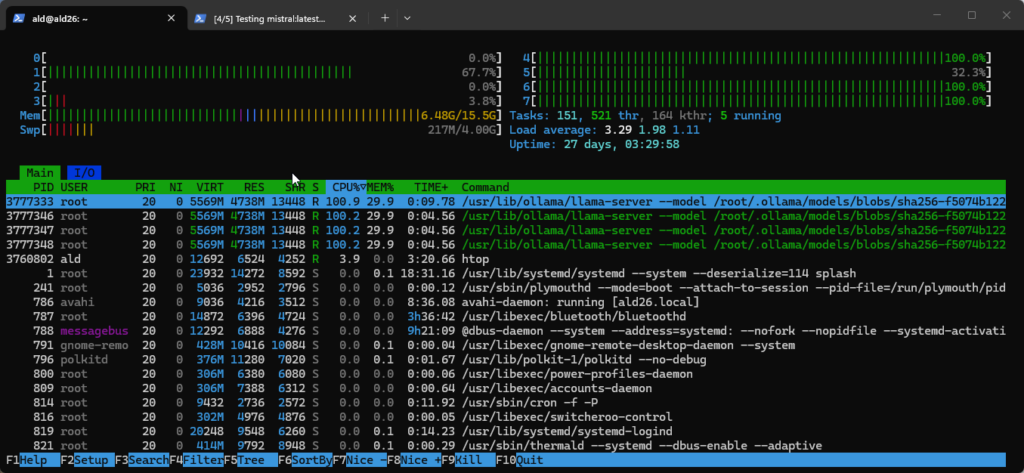
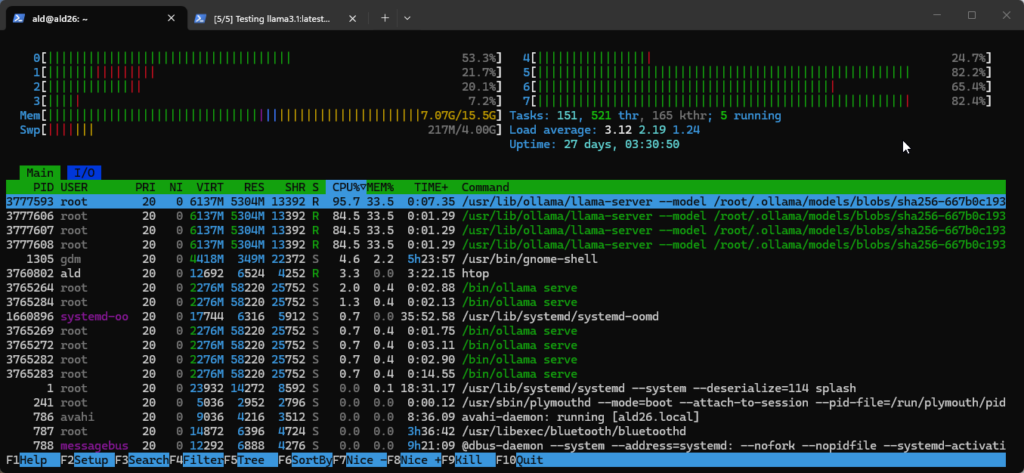
Il n’enregistre en revanche pas les pics de RAM et de CPU du système, c’est pour cela qu’il faut suivre htop en parallèle dans un autre terminal. Voici par exemple une capture d’écran réalisée pendant le test de Gemma 4 E2B. Les 4 autres captures sont tout en bas de l’article :
Résultats
Modèle
Logique
Traduction
Poésie
Vitesse (tok/s)
Temps total
RAM max (htop)
Gemma 4 E2B (5,1B)
Juste (Bleu)
Juste (Cordes)
Juste
9,84
106,78 s
9,16 Go
Qwen 2.5 (3B)
Faux (Rouge)
Faux (hors-sujet)
Juste
8,37
39,63 s
3,92 Go
Qwen 2.5 (7B)
Faux (Rouge)
Juste (Cordes)
Juste
3,78
69,21 s
6,54 Go
Mistral (7B)
Faux (Rouge)
Juste (Cordes)
Juste
3,86
48,92 s
6,48 Go
Llama 3.1 (8B)
Juste (Bleu)
Inexact (« gros traits »)
Juste
3,55
90,98 s
7,07 Go
Gemma 4 E2B est le seul modèle à réussir les trois épreuves sans erreur. Il génère aussi le texte le plus rapidement en tokens par seconde, même si son temps total reste élevé à cause d’une phase de réflexion plus longue avant de produire la réponse. Sa consommation RAM est la plus élevée du lot, ce qui s’explique par le contexte de raisonnement chargé en mémoire.
Les deux modèles Qwen 2.5 7B et Mistral 7B échouent tous les deux sur le problème de logique, en concluant à tort que Bob porte du rouge. Llama 3.1 8B résout correctement la logique mais traduit l’expression de façon moins idiomatique.
Au vu de ces résultats, Gemma 4 E2B devient mon modèle local par défaut. Il n’est pas seulement le plus fiable des cinq sur ce test, c’est aussi le seul de la sélection à traiter nativement le texte, l’image et l’audio. Il peut aussi analyser des vidéos, en les découpant en une séquence d’images.
Cette capacité multimodale ouvre des usages que je n’avais pas avec les autres modèles testés ici, comme la transcription ou la description d’images directement en local. C’est une piste que je compte explorer dans un prochain article. Et je vais aussi l’utiliser comme une sorte d’agent.
Pour aller plus loin
Cet article fait partie de la série Créer une IA locale. Retrouve aussi la série Projets Ubuntu pour tout ce qui touche à l’infrastructure Linux qui héberge ces modèles.
Les copies d’ecran htop pendant les 4 autres essais
Je voulais mettre à jour mes containers Docker avant de lancer une expérmentation. Je ne me suis pas vraiment posé de question, j’ai moins d’une dizaine de containers. J’ai choisi une méthode manuelle, via Portainer, sans perdre leur configuration.
La mise à jour manuelle via Portainer présente trois avantages :
tu choisis exactement quand la coupure de service a lieu
tu vois immédiatement dans les logs si le container redémarre correctement
tu n’ajoutes pas de container supplémentaire qui tourne en permanence
La méthode
Pour chaque container à mettre à jour, sans perdre sa configuration ni ses données (à condition qu’elles soient stockées sur des volumes ou des dossiers hôtes) :
Dans Portainer, va dans Containers et clique sur le container concerné.
Clique sur Re-create (ou Duplicate/Edit selon la version de Portainer) dans la barre d’outils.
Active l’interrupteur Pull latest image.
Valide en cliquant sur Re-create.
Portainer va chercher la nouvelle version de l’image sur Docker Hub, arrête l’ancien container et en relance un nouveau avec les mêmes variables d’environnement, ports et volumes.
Vérifier que la mise à jour s’est bien passée
Une fois le container recréé, vérifie dans Portainer :
que le statut passe bien à running
que les logs du container ne montrent pas d’erreur au démarrage
que le service reste accessible (par exemple, l’interface web du container si elle existe)
Si un container refuse de redémarrer après une mise à jour, la cause la plus fréquente est une incompatibilité entre la nouvelle version de l’image et la configuration existante (variable d’environnement renommée, changement de format de volume, etc.). Dans ce cas, les logs Portainer donnent en général une indication claire du problème.
Pour aller plus loin
Cet article fait partie de la série Projets Ubuntu, qui documente la gestion d’une infrastructure Linux personnelle.
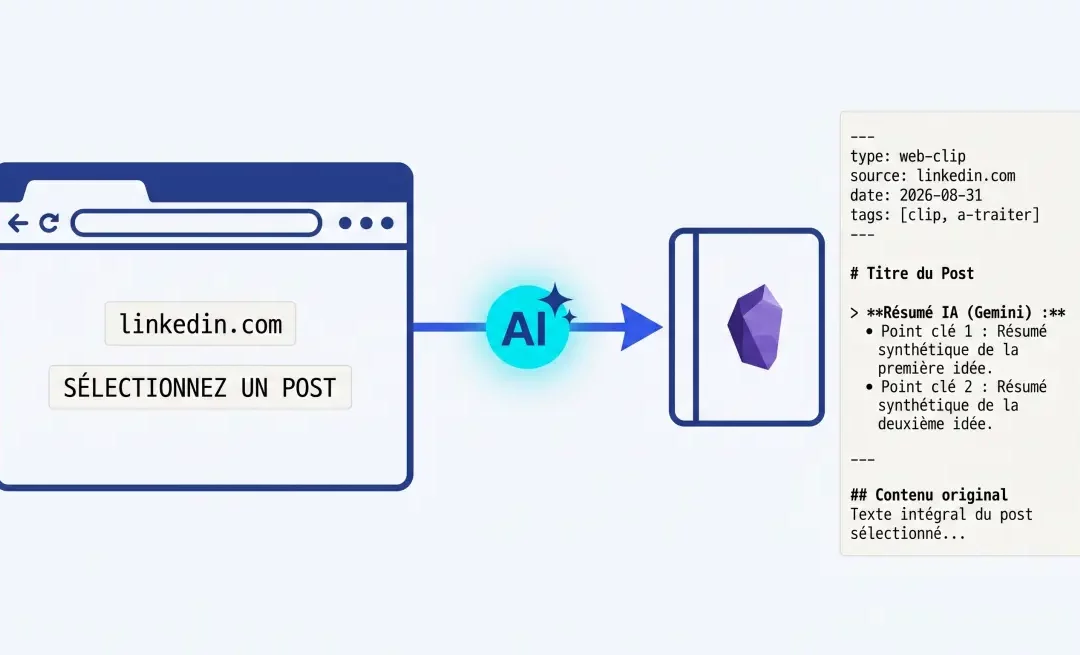
Je voulais capturer des posts LinkedIn intéressants directement dans Obsidian, avec un résumé automatique, sans écrire une ligne de code moi-même. Cet article documente comment j’ai construit cette extension Chrome avec Antigravity, un agent de développement piloté par IA, et l’API Gemini de Google.
Antigravity et les extensions Chrome, en bref
Antigravity est un environnement de développement piloté par un modèle d’IA (Gemini, l’IA de Google). Tu lui donnes des instructions en langage naturel, appelées prompts, et il écrit et modifie les fichiers de code à ta place, dans un dossier sur ton ordinateur.
Une extension Chrome est un petit programme qui s’ajoute au navigateur pour lui donner une fonctionnalité supplémentaire. Depuis 2024, Google impose que toute nouvelle extension respecte un format appelé Manifest V3 (MV3) : un fichier manifest.json qui décrit les permissions demandées et le comportement de l’extension. MV3 impose des règles de sécurité strictes, par exemple limiter les sites sur lesquels l’extension peut agir.
Gemini intervient à trois niveaux distincts dans ce projet, à ne pas confondre :
Gemini en tant que chat : c’est l’interface conversationnelle utilisée en amont, pour discuter du besoin, découper le projet en étapes et rédiger les prompts destinés à Antigravity.
Gemini en tant qu’API : appelée par Antigravity pour concevoir l’application souhaitée. C’est aussi le service que le code de l’extension appelle directement (à l’étape 3), pour générer le résumé du texte capturé.
Une API (interface de programmation) est le canal standardisé par lequel un programme demande un service à un autre.
Le projet : « Web Clipper to Obsidian »
L’objectif : cliquer sur l’icône de l’extension pendant que je consulte une page web, en particulier un post LinkedIn, et obtenir automatiquement dans Obsidian une note contenant :
le texte sélectionné (ou le texte principal de la page si rien n’est sélectionné)
l’image du post
un résumé généré par l’IA Gemini
l’URL source et la date de capture
Obsidian est un logiciel de prise de notes qui stocke tout en fichiers Markdown. Il peut recevoir des notes depuis l’extérieur via un protocole appelé obsidian://, un lien spécial qui, une fois activé, ouvre directement l’application avec le contenu fourni.
Prérequis
Antigravity installé (téléchargement sur antigravity.google/download, connexion avec un compte Google)
Obsidian installé (téléchargement sur obsidian.md), avec un coffre (vault) existant
Une clé API Gemini, avec une alerte de budget configurée (voir plus bas)
Une remarque sur la méthode
Plutôt que de demander à Antigravity de générer l’extension complète en une seule fois, le projet a été découpé en quatre étapes, chacune ajoutant une seule fonctionnalité testable. Cadrer le besoin puis avancer par petites briques validées une à une est une méthode de travail à part entière, détaillée dans un article dédié sur parcours-performance.com (lien ajouté prochainement).
Étape 1 : squelette fonctionnel
Objectif : au clic sur l’icône de l’extension, ouvrir une note de test dans Obsidian, pour valider que la liaison entre Chrome et Obsidian fonctionne.
Prompt donné à Antigravity :
Role: Expert Chrome Extension Developer (Manifest V3)

Context:
Nous démarrons le développement d'une extension Google Chrome nommée "Web Clipper to Obsidian". Ce projet suit une approche itérative en 4 étapes. Nous exécutons actuellement l'Étape 1 (POC / Squelette fonctionnel).

Objectif de l'Étape 1:
Créer le squelette de l'extension. Lors d'un clic sur l'icône de l'extension, l'application doit immédiatement ouvrir une nouvelle note dans Obsidian via le protocole natif `obsidian://new` avec un contenu de test statique, pour valider la chaîne de liaison.

Consignes d'architecture et de sécurité:
1. Utilise impérativement Manifest V3.
2. Applique le principe du moindre privilège : demande uniquement les permissions nécessaires pour cette étape. Ne pas utiliser `<all_urls>`.
3. Utilise l'action de clic directe (`chrome.action.onClicked`) sans afficher de pop-up HTML pour le moment, afin de garantir une expérience zéro-clic.
4. Assure-toi que les titres de fichiers sont "sanitisés" (suppression/remplacement des caractères interdits par les systèmes de fichiers comme `/ \ : * ? " < > |`).

Format de la note de test générée dans Obsidian:
- Titre : "Test Clip - [Date du jour]"
- Vault par défaut : "MonVault" (variable à rendre facilement modifiable au début du code)
- Contenu Markdown :
  ---
  type: web-clip-test
  date: [Date du jour]
  ---
  # Test de connexion réussit !
  Ceci est un clip de test généré depuis mon extension Chrome.

Livrables attendus :
1. Génère les fichiers nécessaires pour que l'extension soit directement chargeable dans Chrome via "Charger l'extension non empaquetée".
2. Donne de courtes instructions pour tester l'extension dans Chrome et Obsidian.
POC est l’abréviation de « proof of concept » (preuve de concept) : une version minimale qui sert uniquement à vérifier qu’une idée fonctionne techniquement, avant d’y ajouter des fonctionnalités.
Comme demandé dans le prompt (« donne de courtes instructions pour tester »), Antigravity a lui-même fourni la marche à suivre pour essayer ce qu’il venait de produire. Ça fonctionne dès le premier essai.
À noter : le prompt demande de nettoyer les titres de fichiers en remplaçant les caractères interdits par un système de fichiers (/ \ : * ? " < > |) par des tirets. Ce nettoyage, parfois appelé « sanitisation » (un anglicisme calqué sur « sanitize« ), ne couvre à ce stade que ces caractères interdits, pas les accents. Cette limite se révélera plus loin, quand un titre accentué produira un nom de fichier posant problème : le nettoyage sera alors complété pour gérer aussi ce cas.
Étape 2 : extraction du contenu de la page
Objectif : rendre l’extension capable de lire le titre, l’URL et le texte sélectionné (ou à défaut le texte principal) de la page web active.
Prompt donné à Antigravity :
Role: Expert Chrome Extension Developer (Manifest V3)

Context:
L'Étape 1 est validée avec succès : l'extension parvient à ouvrir Obsidian et à y créer une note de test via `obsidian://new`. Nous passons à l'Étape 2.

Objectif de l'Étape 2:
Capturer dynamiquement les informations de la page web active (`activeTab`) lors du clic sur l'icône de l'extension et les transmettre à la note Obsidian.

Spécifications techniques :
1. Mise à jour de Manifest V3 :
   - Conserver les règles de sécurité strictes (pas de `<all_urls>`).
   - Ajouter la permission `scripting` si nécessaire pour exécuter un Content Script éphémère sur l'onglet actif.
2. Logique d'extraction (Content Script) :
   - Récupérer le titre de la page (`document.title`).
   - Récupérer l'URL exacte de la page (`window.location.href`).
   - Récupérer le texte sélectionné par l'utilisateur à la souris (`window.getSelection().toString()`).
   - SI aucun texte n'est sélectionné : récupérer le texte principal de la page ou du post (fallback).
3. Traitement et sécurité des données :
   - Nettoyer le titre pour le nom du fichier Markdown (remplacer les caractères interdits `/ \ : * ? " < > |` par des tirets).
4. Formatage de la note Obsidian générée :
   ---
   type: web-clip
   source_url: "[URL_DE_LA_PAGE]"
   date_capture: [Date du jour YYYY-MM-DD]
   tags: [clip, a-traiter]
   ---
   # [TITRE_DE_LA_PAGE]

   ## Contenu extrait
   [TEXTE_SELECTIONNE_OU_EXTRAIT]

Livrables attendus :
Met à jour le code de l'extension et indique-moi quand effectuer le rechargement dans `chrome://extensions` pour tester l'extraction sur une vraie page web (ou un post LinkedIn).
Un Content Script est un petit programme que l’extension injecte temporairement dans la page web visitée, pour pouvoir en lire le contenu.
À noter : à ce stade, aucune IA n’intervient. Il s’agit de programmation classique, qui va chercher dans la page (le DOM, la structure de la page web) le titre, l’URL et le texte sélectionné. L’IA n’entrera en jeu qu’à l’étape 3, pour interpréter ce contenu.
Après chaque modification du code par Antigravity, l’extension doit être rechargée avant de pouvoir tester la nouvelle version : sur chrome://extensions, cliquer sur l’icône de rafraîchissement (flèche circulaire) de la fiche de l’extension. Sans ce rechargement, Chrome continue de faire tourner l’ancienne version du code.
Obtenir et sécuriser une clé API Gemini
Avant l’étape 3, il faut une clé API Gemini. Une clé API est un identifiant unique qui permet à un programme d’utiliser un service en ligne (payant à l’usage ou pas), ici l’IA Gemini de Google.
Pour l’obtenir :
Va sur aistudio.google.com et connecte-toi avec ton compte Google.
Accepte les conditions d’utilisation si c’est ta première visite.
Clique sur « Get API key » (Obtenir une clé API), puis sur « Créer une clé API ».
Choisis « Créer une clé dans un nouveau projet », donne-lui un nom.
Copie la clé générée et garde-la confidentielle : ne la partage nulle part, ne la mets jamais en clair dans du code que tu publies.
Le tarif de l’API Gemini dépend du volume de requêtes. Pour un usage personnel, le risque principal n’est pas le montant en lui-même mais une dérive non surveillée, par exemple un bug qui déclenche des appels en boucle. Deux précautions simples permettent de s’en prémunir :
Utiliser un moyen de paiement à plafond limité. Associer le compte de facturation Google Cloud à une carte dont les dépenses ne peuvent pas dépasser le solde disponible (une carte de type Nickel, par exemple), plutôt qu’à une carte bancaire classique adossée à un compte principal.
Configurer une alerte de budget dans Google Cloud. La marche à suivre :
Va sur console.cloud.google.com, connecté avec le compte Google concerné.
Sélectionne le projet créé pour l’API Gemini dans le sélecteur de projet en haut de l’écran.
Dans le menu de gauche ou la barre de recherche, cherche « Facturation », puis la section « Budgets et alertes ».
Clique sur « Créer un budget ».
Donne un nom au budget (par exemple alerte-budget-api).
Vérifie que le champ d’application est limité au projet courant.
Renseigne un montant très bas, par exemple 1 €.
Conserve les seuils d’alerte proposés par défaut (50 %, 90 % et 100 % du montant) : avec un budget aussi bas, ils suffisent largement à prévenir dès la moindre dépense.
Enregistre.
Ces deux précautions prises, la clé peut être utilisée dans l’extension.
Étape 3 : connexion à l’API Gemini
Objectif : envoyer le texte extrait à l’API Gemini pour générer un résumé, et l’intégrer dans la note Obsidian.
Prompt donné à Antigravity :
Role: Expert Chrome Extension Developer (Manifest V3)

Context:
L'Étape 2 est validée avec succès : l'extension extrait le texte, l'URL et le titre, et crée la note dans Obsidian. Nous passons à l'Étape 3 : l'intégration de l'API Google Gemini.

Ajustement obligatoire :
- Fixe le nom du Vault Obsidian par défaut sur : "MonVault".

Objectif de l'Étape 3:
Envoyer le texte extrait à l'API Google Gemini pour générer un résumé synthétique du contenu, puis intégrer ce résumé dans la note Obsidian.

Spécifications techniques :
1. Clé API Gemini (Provisoire pour le test) :
   - Ajoute une variable de configuration explicite `const GEMINI_API_KEY = "TA_CLE_API_ICI";` dans le script de background.
   - Prévois une vérification : si la clé vaut "TA_CLE_API_ICI", l'extension doit sauter l'étape IA et créer la note directement comme à l'Étape 2 (fallback sécurisé).
2. Appel à l'API Gemini :
   - Endpoint : API REST Gemini.
   - Prompt système pour Gemini :
     "Tu es un assistant de prise de notes. Analyse le texte suivant extrait d'une page web/LinkedIn. Génère un résumé clair et concis en 2 à 3 puces grand maximum. Réponds UNIQUEMENT avec le résumé au format Markdown."
3. Formatage final de la note Obsidian :
   ---
   type: web-clip
   source_url: "[URL_DE_LA_PAGE]"
   date_capture: [Date du jour YYYY-MM-DD]
   tags: [clip, résumé-ia, a-traiter]
   ---
   # [TITRE_DE_LA_PAGE]

   > **Résumé IA (Gemini) :**
   > [RÉSUMÉ_GÉNÉRÉ_PAR_GEMINI]

   ---

   ## Contenu original extrait
   [TEXTE_EXTRAIT]
4. Feedback visuel (UX) :
   - Pendant que l'API Gemini répond, change temporairement le badge de l'icône de l'extension pour indiquer à l'utilisateur que l'IA travaille.

Livrables attendus :
Mets à jour le code de l'extension et explique-moi où coller ma clé API Gemini pour tester l'Étape 3.
API est l’abréviation d' »application programming interface » (interface de programmation) : le canal standardisé par lequel un programme peut demander un service à un autre. REST est un style d’architecture couramment utilisé pour ces API, où chaque requête s’envoie par une URL. UX est l’abréviation d' »user experience » (expérience utilisateur) : la façon dont l’usage du produit se ressent concrètement.
À noter : ce prompt contient un prompt dans le prompt. Le texte donné à Antigravity (« Tu es un assistant de prise de notes… ») n’est pas une instruction pour Antigravity lui-même : c’est le texte que le code, une fois écrit, enverra à son tour à l’API Gemini à chaque clip. Antigravity ne l’exécute pas, il l’intègre tel quel dans le code qu’il génère.
Suivre et corriger les erreurs
Cette étape n’a pas fonctionné du premier coup. L’API a d’abord renvoyé une erreur 404 (ressource introuvable), le nom du modèle Gemini demandé par le code n’étant plus valide. Google fait évoluer régulièrement les noms de modèles disponibles, ce qui rend ce type d’erreur fréquent avec une IA en développement rapide.
Pour diagnostiquer ce genre de problème, la console de développement de Chrome est l’outil de référence :
Va sur chrome://extensions.
Sur la fiche de l’extension, clique sur le lien « Service Worker » sous « Inspecter les vues ».
Dans la fenêtre qui s’ouvre, clique sur l’onglet « Console ».
Relance un clip depuis une page web : le message d’erreur exact s’affiche en rouge.
Plusieurs allers-retours ont été nécessaires pour corriger le nom du modèle. Mais le vrai point de bascule est venu d’une relecture attentive du code généré : une clé API par défaut factice s’y trouvait dupliquée à deux endroits différents (background.js et options.js), ce qui masquait silencieusement le vrai problème en remplaçant une clé vide par une fausse valeur plutôt que de signaler l’erreur. Un agent de code peut corriger un symptôme sans traiter la cause, si on ne le questionne pas sur la cohérence d’ensemble.
Deux réflexes utiles face à une erreur qui persiste : relire soi-même le code généré, dans la mesure de ses compétences, pour repérer les incohérences visibles (doublons, valeurs codées en dur, logique redondante) ; et, si la lecture directe du code n’est pas possible, le transmettre à un chat comme Gemini en lui demandant explicitement s’il identifie une cause aux erreurs rencontrées. L’agent de code qui a écrit le programme n’est pas toujours le mieux placé pour en questionner la cohérence d’ensemble.
Une fois le code nettoyé et le nom du modèle corrigé, le résumé Gemini s’est généré correctement à chaque test.
Étape 4 : sécurisation et finitions
Objectif : sortir la clé API et le nom du vault du code source pour les placer dans une page d’options dédiée, et ajouter un retour visuel pendant le traitement.
Cette étape n’est pas un simple confort : une clé API ou un nom de vault codés « en dur » dans les fichiers JavaScript se retrouvent visibles dès qu’on partage le code, qu’on le publie, ou qu’on l’inspecte via les outils de développement de Chrome. Toute valeur confidentielle ou spécifique à un utilisateur doit être stockée séparément, jamais écrite directement dans le code source.
Prompt donné à Antigravity :
Role: Expert Chrome Extension Developer (Manifest V3)

Context:
L'Étape 3 est un succès total (extraction texte + image + résumé Gemini + export Obsidian sans erreur).
Nous passons à l'Étape 4 : la sécurisation des paramètres et les finitions UX.

Objectifs de l'Étape 4 :
1. Déplacer la clé API Gemini et le nom du Vault Obsidian dans une page d'options dédiée.
2. Ajouter des indicateurs visuels d'état sur l'icône de l'extension.

Spécifications techniques :

1. Page d'options Chrome (`options.html` + `options.js`) :
   - Crée une page de paramètres accessible via un Clic Droit sur l'icône de l'extension -> "Options".
   - Propose deux champs de saisie :
     a. Clé API Gemini (type `password` pour la masquer).
     b. Nom du Vault Obsidian (valeur par défaut : "MonVault").
   - Utilise le stockage de l'extension pour enregistrer et charger ces paramètres.
   - Mets à jour `background.js` pour qu'il récupère la clé et le vault depuis ce stockage avant de lancer la requête.
   - Si la clé est manquante lors d'un clic, ouvre automatiquement la page d'options.

2. Feedback visuel (UX) :
   - Au moment du clic : affiche un badge bleu "..." sur l'icône de l'extension.
   - Une fois la note créée : affiche un badge vert "OK" pendant 2 secondes, puis efface-le.
   - En cas d'erreur : affiche un badge rouge "ERR" pendant 3 secondes.

Mets à jour le projet et indique-moi quand effectuer le rechargement final dans Chrome.
Pour configurer : recharger l’extension, clic droit sur son icône, « Options », saisir la clé API et le nom du vault, enregistrer. Au clip suivant, le badge bleu s’affiche pendant le traitement, puis un badge vert confirme la création de la note dans Obsidian.
État actuel et limites connues
La capture de l’image du post reste peu fiable lorsqu’elle se fait depuis le fil d’actualité LinkedIn (l’extension récupère parfois l’image d’un post voisin dans le flux), alors qu’elle fonctionne correctement depuis la page dédiée à un post précis. Une phase d’amélioration est prévue pour affiner ce point, ainsi que pour étendre l’extension à d’autres sites que LinkedIn.
Bilan
Quatre prompts structurés, quelques allers-retours de débogage guidés par la console Chrome, et une extension fonctionnelle capable de capturer du texte et une image, de les faire résumer par une IA, et de créer une note Obsidian prête à l’emploi, sans écrire une ligne de code à la main. La méthode de découpage en étapes testables et de rédaction des prompts est reprise en détail dans un article dédié sur parcours-performance.com (lien à indiquer).
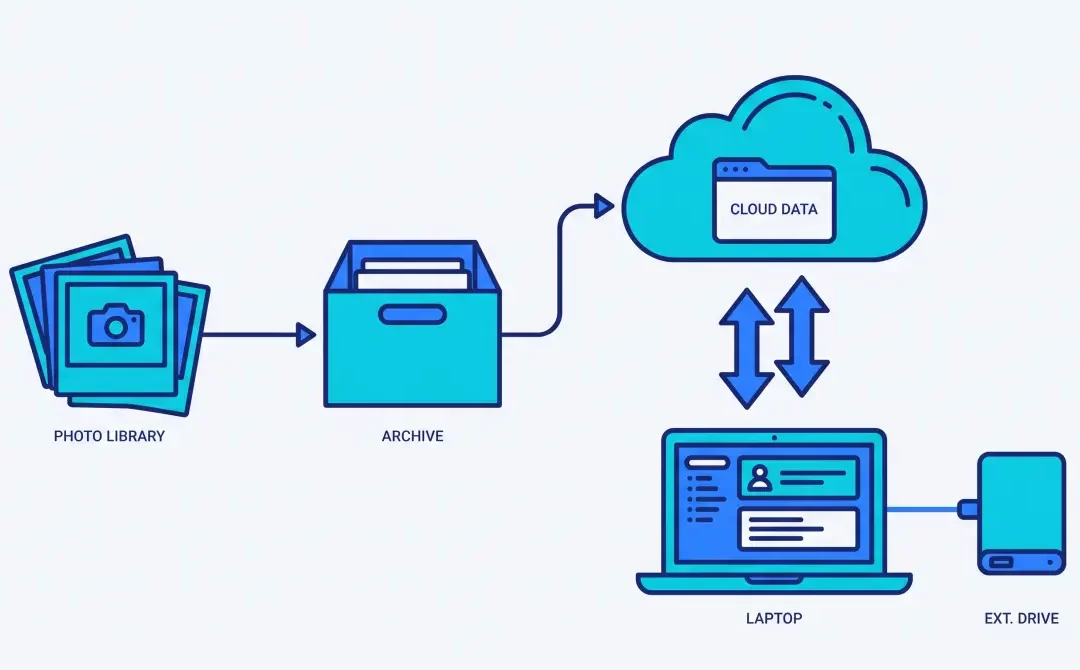
Ta bibliothèque de photos est probablement synchronisée sur Google Photos, sans autre copie. En cas de perte de compte, piratage ou suspension, cette bibliothèque disparaît. Voici comment en récupérer une copie indépendante grâce à Google Takeout, jusqu’à un disque local.
Pourquoi Google Takeout, et pas rclone directement
Depuis fin mars 2025, l’API que rclone utilise pour Google Photos a été restreinte par Google : rclone ne peut plus télécharger que les photos qu’il a lui-même envoyées, pas l’ensemble d’une bibliothèque déjà existante. rclone n’est donc plus une option pour extraire directement tes photos. Google Takeout reste la méthode recommandée pour un export complet, avec les métadonnées d’origine.
Étape 1 : créer l’export avec Google Takeout
Dans les paramètres de ton compte Google Photos, va dans Exporter vos données > Sauvegarder
Crée une exportation, choisis ce que tu veux sauvegarder (l’ensemble de ta bibliothèque par exemple)
Vérifie la destination : par défaut, Google Takeout propose d’envoyer un lien de téléchargement par e-mail. Remplace cette destination par Envoyer à Drive. Il y a d’autres options, pas pertinentes pour moi : Dropbox, OneDrive, Box). Nextcloud n’est pas proposé.
Choisis « Exporter une fois », format .zip, taille de fichier 2 Go
Clique sur « Créer une exportation »
Attends l’e-mail de fin de traitement, le délai peut aller jusqu’à plusieurs heures selon le volume de ta bibliothèque
Étape 2 : récupérer l’export dans un dossier Google Drive dédié
L’export atterrit dans un dossier Takeout créé automatiquement par Google, mélangé au reste de ton Drive. Mieux vaut le déplacer dans un dossier dédié avant de passer à la suite :
Ouvre Google Drive, dossier Takeout. Il est à la racine de « Mon Drive »
Déplace ce dossier Takeout là où ça te semble pertinent
Étape 3 : synchroniser ce dossier avec un disque local
Google Photos et Google Drive sont deux services Google distincts : un problème sur l’un (compte Photos suspendu, par exemple) n’affecte pas nécessairement l’autre. Mais pour être vraiment protégé, il faut une copie qui sorte de l’écosystème Google, sur un support que tu maîtrises entièrement.
La méthode la plus simple : installer le client de synchronisation Google Drive sur ton PC (Windows ou macOS), et le laisser synchroniser ce dossier dédié vers un dossier local sur ton disque dur. Une fois la synchronisation terminée, tu disposes d’une copie physique de tes photos sur ta machine, indépendante de toute connexion internet ou de la disponibilité de Google Photos.
Ce qui reste à faire
Cette copie locale reste, pour l’instant, sur le même PC que celui utilisé au quotidien pour accéder à Google Drive. Une indépendance complète de l’écosystème Google viendra d’une copie supplémentaire sur un support totalement déconnecté : disque dur externe débranché en dehors des sauvegardes, ou gravure sur DVD pour un archivage à très long terme. Cette étape suivante n’est pas encore réalisée à l’heure où j’écris cet article, elle fera l’objet d’un complément le moment venu.
Conclusion
En cas de problème sur Google Photos, tant que Google Drive reste accessible, la bibliothèque de photos existe encore, à cet endroit précis. Et depuis l’étape de synchronisation locale, elle existe aussi sur le disque dur du PC, sans dépendre de la disponibilité d’aucun service Google. C’est un exemple concret du principe décrit dans Les limites cachées des solutions cloud : le cloud seul ne suffit jamais, une copie locale reste le seul vrai filet de sécurité.
Le cloud donne une impression de capacité illimitée, où il suffirait de lancer une commande pour que tout se transfère sans effort. La réalité est bien différente. Aucune solution n’est parfaite. Voici trois limites rencontrées sur trois services différents (Dropbox, Google Drive, Nextcloud), et la conclusion qui en découle : ne jamais dépendre uniquement du cloud pour tes données importantes.
Cet article fait partie de la série Projets Ubuntu, consacrée à mon Mini PC sous Ubuntu et son infrastructure Docker.
Dropbox : une API très sensible à la concurrence
En migrant plusieurs dizaines de milliers de fichiers Dropbox vers Google Drive avec rclone, le débit s’est effondré à quelques centaines de kilo-octets par seconde, alors que la connexion utilisée tenait sans problème plusieurs centaines de mégabits. La cause : l’API Dropbox tolère très mal un grand nombre de requêtes simultanées sur de nombreux petits fichiers, contrairement à Google Drive qui encaisse ce type de charge sans broncher. La solution qui a fonctionné : synchroniser d’abord Dropbox sur un disque local avec le client de bureau habituel, puis transférer ce disque vers Google Drive avec rclone, sans jamais repasser par l’API Dropbox pour ce volume de fichiers.
Google Drive : un quota de requêtes partagé par défaut
Sans configuration particulière, rclone se connecte à Google Drive avec un identifiant d’application qui lui est propre, partagé par tous les utilisateurs de rclone dans le monde qui n’ont pas configuré leurs propres identifiants. Le quota de requêtes par minute de cet identifiant partagé peut donc être atteint à cause de l’usage d’autres personnes, totalement indépendamment du volume que tu transfères toi-même. Ça se traduit par une erreur de ce type, sans rapport apparent avec ce que tu es en train de faire :
RATE_LIMIT_EXCEEDED
La solution : créer son propre projet Google Cloud, avec ses propres identifiants OAuth, pour disposer d’un quota qui n’appartient qu’à toi et non plus partagé avec le reste du monde. La démarche complète (création du projet, activation de l’API, génération des identifiants, reconfiguration de rclone) fait l’objet d’un article dédié, à paraître.
Nextcloud : une limite structurelle sur les gros fichiers via WebDAV
Cette troisième limite est la plus difficile à diagnostiquer, parce qu’elle ne vient ni d’un quota, ni d’une mauvaise configuration, mais d’un bug connu et documenté du protocole utilisé.
Le contexte : transférer un export Google Photos (Google Takeout) depuis Google Drive vers un espace Nextcloud, avec des fichiers ZIP d’environ 2 Go chacun. Commande de départ :
Le fichier temporaire créé par Nextcloud pendant l’envoi (.upload.part) reste verrouillé, rclone considère alors le transfert comme échoué et redémarre l’envoi du fichier entier depuis zéro. Résultat : plus d’une heure passée à recommencer plusieurs fois le même fichier de 2 Go, sans jamais aboutir.
Deux pistes ont été testées avant de trouver la vraie cause :
Mettre à jour rclone vers une version récente, pour bénéficier du découpage automatique des gros fichiers en petits blocs (chunking) lors de l’envoi vers Nextcloud, une fonctionnalité absente des versions plus anciennes
Ajuster la taille de ces blocs avec l’option --webdav-nextcloud-chunk-size, en restant sous la limite d’upload fixée par l’hébergeur (visible dans les paramètres PHP, « Taille maximum d’un fichier pour l’envoi »)
Aucune des deux n’a résolu le problème de fond : même avec une version récente et des blocs correctement dimensionnés, le même verrou 423 Locked est réapparu lors de l’assemblage final des blocs côté serveur. En creusant du côté des tickets techniques du projet rclone, la cause est confirmée par les développeurs eux-mêmes : il n’existe aucun moyen fiable de vérifier si cet assemblage, effectué côté serveur Nextcloud, est encore en cours ou a échoué. Si l’assemblage prend un peu de temps, ce qui est normal pour un gros fichier, rclone peut l’interpréter comme un échec et relancer tout l’envoi. C’est un problème ouvert depuis plusieurs années, qui touche spécifiquement les gros fichiers envoyés à un serveur Nextcloud via le protocole WebDAV.
Autrement dit : ni une mauvaise configuration, ni une version obsolète, mais une limite structurelle qui touche cette combinaison précise d’outil et de protocole, pour ce type de fichier volumineux. La règle qui en découle : garder les fichiers sous 500 Mo à 1 Go pour un envoi vers Nextcloud, avec --transfers 1, et désactiver le découpage en blocs quand le fichier tient dans la limite d’upload de l’hébergeur. Pour les fichiers plus gros, comme un export Google Takeout, une autre méthode est nécessaire, elle fait l’objet d’un article dédié.
La conclusion commune : le cloud ne remplace jamais une sauvegarde locale
Ces trois limites n’ont techniquement rien en commun : une API sensible à la charge, un quota partagé par défaut, un bug de verrouillage sur un protocole de transfert. Mais elles partagent le même enseignement : aucune automatisation cloud à cloud n’est garantie de bout en bout. Un transfert peut caler à mi-chemin, pour une raison qui n’a parfois rien à voir avec la taille des données ou la qualité de la connexion.
C’est pour ça qu’une copie locale, sur un disque que tu maîtrises entièrement, reste indispensable en complément de toute sauvegarde cloud. Pas comme solution de confort, mais comme filet de sécurité pour le jour où un transfert automatisé n’ira pas au bout, ou pour le jour où il faudra tout simplement sortir d’un service cloud, avec ou sans sa coopération.
J’ai perdu l’outil de capture d’écran que j’utilisais jusqu’ici, pratique au quotidien. Je me suis tournée vers ShareX, un logiciel gratuit et open source pour Windows, riche en fonctionnalités.
Pourquoi ShareX
ShareX permet de capturer une zone d’écran, de l’annoter directement, puis de la copier ou de l’enregistrer. Il propose beaucoup plus de possibilités qu’un simple outil de capture basique, notamment un éditeur d’annotation complet. Voir toutes les possibilités sur le site : https://getsharex.com/
Le raccourci de capture
J’utilise le raccourci prédéfini Ctrl + Impr écran pour lancer une capture de zone.
Configurer les tâches après la capture
Par défaut, ShareX propose plusieurs actions automatiques une fois la capture réalisée. Dans le menu « Tâches après la capture », seules « Copier l’image dans le presse-papier » et « Enregistrer l’image comme fichier » étaient cochées.
J’ai ajouté l’option « Afficher le menu des tâches rapides ». Elle ouvre l’éditeur d’annotation juste après la capture, avant toute copie ou sauvegarde. Cela permet d’annoter l’image immédiatement, ce qui est très utile pour expliquer une manipulation ou pointer un élément précis à l’écran.
Les outils d’annotation
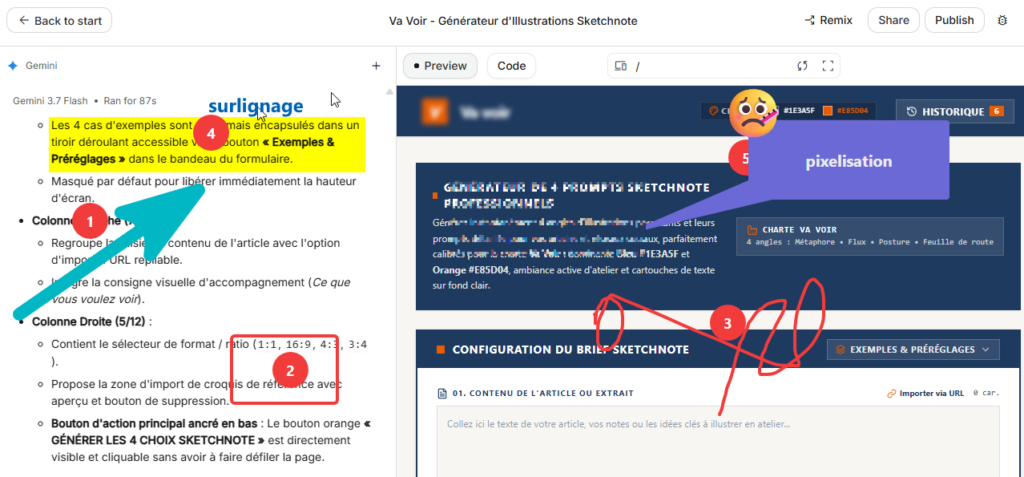
L’éditeur intégré propose de nombreux outils de dessin. Sur l’exemple ci-dessous, on retrouve :
Flèche, pour pointer un élément précis
Forme, ici un rectangle, pour encadrer une zone
Trait libre, pour dessiner à main levée
Surligner, pour mettre en évidence du texte ou une zone
Pixeliser une zone, combiné ici avec une boîte de texte et un émoticône, pour flouter une information tout en la commentant
En résumé
ShareX est un outil complet, gratuit, qui va bien au-delà de la simple capture d’écran. L’ajout du menu de tâches rapides après la capture m’a fait gagner du confort : je peux annoter à chaud, sans étape supplémentaire.
Tu synchronises déjà tes fichiers en temps réel entre plusieurs appareils, mais une synchronisation n’est pas une sauvegarde : une erreur ou une suppression accidentelle se propage aussi vite que le reste. Voici comment mettre en place une sauvegarde périodique automatisée d’un service cloud vers un autre, avec un script simple et fiable.
y, puis saisis le mot de passe Nextcloud (il sera masqué et stocké de façon obscurcie dans rclone.conf, pas en clair)
bearer_token>
Laisse vide, valide
Edit advanced config?
n
Keep this remote?
y
q) Quit config
q
Pour vérifier que c’est ok :
rclone lsd nextcloud:OBSIDIAN-sync
Tu dois voir le contenu de ton dossier OBSIDIAN-sync dans Nextcloud.
Étape 2 : configurer un remote vers la destination, limité à un dossier particulier
Par prudence, plutôt que de donner à rclone un accès à l’intégralité de ton espace de stockage de destination, il est possible de limiter un remote à un seul dossier, appelons le « folder », grâce à son identifiant unique.
Récupérer l’identifiant du dossier
Ouvre le dossier cible dans Google Drive, depuis un navigateur
Copie la chaîne de caractères qui suit folders/ dans l’URL, par exemple :
Choisis de créer un nouveau remote « gdrive-scope », sélectionne drive comme type de stockage, laisse les champs client_id et client_secret vides (valeurs par défaut), puis, à l’étape des réglages avancés (réponds y à la question Edit advanced config?), renseigne le champ root_folder_id avec l’identifiant récupéré à l’étape précédente.
Autoriser l’accès sans navigateur local (connexion SSH)
Si tu configures ce remote depuis une session SSH sans interface graphique, l’assistant propose une autorisation manuelle : il faut alors lancer rclone authorize "drive" sur une machine disposant d’un navigateur, se connecter avec le compte Google concerné, puis copier le jeton généré dans le terminal SSH en attente.
Vérifier l’accès
bash
rclone lsd gdrive-scope:
Cette commande devrait lister directement le contenu du dossier ciblé, sans que tu aies besoin de préciser de chemin.
Étape 3 : le script de sauvegarde
Le script copie le contenu source dans un dossier temporaire, le compresse en une seule archive, puis envoie cette archive vers la destination. Il prend en paramètre le nom du sous-dossier à sauvegarder, ce qui permet de le réutiliser pour plusieurs contenus différents avec une seule et même logique. En cas de besoin, l’archive se décompresse normalement pour retrouver les fichiers d’origine.
Attention, il faudra que tu modifies SOURCE_REMOTE (nextcloud:chemin-source/) et DEST_REMOTE (gdrive-scope:destination/) et tu remplaces USER par ton nom d’utilisateur dans le mini PC
#!/bin/bash
# Sauvegarde d'un dossier source (cloud A) vers un dossier destination (cloud B)
# Usage : backup-cloud-to-cloud.sh <nom-du-dossier>
# Exemple : backup-cloud-to-cloud.sh mon-dossier

set -e

FOLDER_NAME="$1"

if [ -z "$FOLDER_NAME" ]; then
  echo "Erreur : nom du dossier manquant. Usage : backup-cloud-to-cloud.sh <nom-du-dossier>"
  exit 1
fi

TIMESTAMP=$(date +%Y%m%d_%H%M%S)
TMP_BASE="/home/USER/tmp/cloud-backup"
TMP_DIR="${TMP_BASE}/${FOLDER_NAME}"
ARCHIVE_NAME="${FOLDER_NAME}_${TIMESTAMP}.tar.gz"
ARCHIVE_PATH="${TMP_BASE}/${ARCHIVE_NAME}"
SOURCE_REMOTE="nextcloud:chemin-source/${FOLDER_NAME}"
DEST_REMOTE="gdrive-scope:destination/${FOLDER_NAME}/"

echo "=== Sauvegarde ${FOLDER_NAME} - $(date) ==="

# Nettoyage préalable au cas où une exécution précédente aurait échoué
rm -rf "$TMP_DIR"
mkdir -p "$TMP_DIR"

# Copie depuis le cloud source vers un dossier temporaire local
echo "Copie depuis la source..."
rclone copy "$SOURCE_REMOTE" "$TMP_DIR" --transfers 4 --checkers 8 --fast-list

# Compression en une seule archive
echo "Compression..."
tar -czf "$ARCHIVE_PATH" -C "$TMP_BASE" "$FOLDER_NAME"

# Upload de l'archive unique vers la destination
echo "Upload vers la destination..."
rclone copy "$ARCHIVE_PATH" "$DEST_REMOTE" --transfers 1

# Nettoyage
rm -rf "$TMP_DIR"
rm -f "$ARCHIVE_PATH"

echo "=== Terminé - $(date) ==="
Si ce script tourne sur une machine où tu utilises sudo pour d’autres tâches, ne l’utilise jamais avec rclone. La commande sudo rclone réécrit le fichier de configuration rclone.conf avec les droits root lors du renouvellement d’un jeton d’accès, ce qui casse ensuite l’utilisation normale de rclone en tant qu’utilisateur courant. Seule une éventuelle commande tar nécessitant des droits élevés (rare dans ce cas précis, puisque le script travaille dans le dossier personnel de l’utilisateur) justifierait sudo, jamais rclone lui-même.
Étape 4 : planifier avec cron
Pour une sauvegarde hebdomadaire, chaque dimanche à 4h du matin :
La fréquence gagne à être adaptée à la criticité du contenu : un document en cours d’écriture active justifie un rythme hebdomadaire, un dossier de veille alimenté plus occasionnellement peut se contenter d’un rythme mensuel.
Assure-toi que le dossier de logs existe avant la première exécution planifiée :
bash
mkdir -p /home/USER/scripts/logs
Étape 5 : tester avant de laisser cron s’en charger
Un test manuel permet de vérifier le bon fonctionnement avant de dépendre entièrement de la planification automatique :
Vérifie ensuite, dans l’interface web du service de destination, que l’archive est bien apparue au bon endroit, avec un nom cohérent incluant l’horodatage.
Ce que ce schéma permet au-delà de ce cas précis
Ce principe (remote limité à un dossier, compression en une seule archive, upload unique, planification cron) se réutilise pour n’importe quelle paire de services cloud supportés par rclone, pas seulement Nextcloud vers Google Drive. C’est un schéma générique de sauvegarde périodique, applicable à d’autres contenus que des notes ou des documents.
Pour aller plus loin
Si ce projet t’intéresse, deux articles complémentaires détaillent la suite :

Commentaires récents